Nội dung
- Bối cảnh model AI mới: danh tiếng phải đi qua bài test công việc
- Opus 5.5 trong bộ nguồn — phần nào đội marketing kiểm tra được
- Quyền mặc cả model AI nằm ở chi phí sai và khả năng hoàn tất việc
- Dự đoán GPT-6.1 Astra chưa được xác nhận: người mua nên tin đến đâu?
- Marketer Việt và model AI mới: dữ liệu tiếng Việt phải đứng trong bài test
- Chấm điểm model AI bằng đầu ra trước khi đổi công cụ
- Nguồn tham khảo
Giá trị của model AI mới không còn nằm chủ yếu ở tên phiên bản hay lời hứa về năng lực tổng quát. Với marketer Việt Nam, quyền mặc cả đang chuyển về phía người mua nào có bài test sát công việc, vì họ có thể chứng minh model nào thật sự hoàn tất đầu ra cần dùng.
Điều này quan trọng khi các thảo luận quanh Opus 5.5, GPT-6 và DevDay vẫn đan xen giữa trải nghiệm cá nhân, suy đoán và tín hiệu chưa được hãng xác nhận. Doanh nghiệp không nên lập ngân sách hoặc đổi công cụ chỉ vì một model đang được cộng đồng nhắc nhiều.
Điểm chính
- Bài test công việc cụ thể cho thấy khoảng cách giữa danh tiếng model và khả năng hoàn tất nhiệm vụ.
- Opus 5.5 và các model được nhắc trong nguồn chưa tạo thành bằng chứng độc lập để kết luận bên nào thắng tuyệt đối.
- Tín hiệu về GPT-6.1 Astra và kỳ vọng quanh DevDay cần được xem là phỏng đoán, không phải dữ liệu mua hàng.
- Đội marketing Việt nên chấm model bằng đầu ra, lỗi, giới hạn sử dụng và chi phí kiểm soát.
Bối cảnh model AI mới: danh tiếng phải đi qua bài test công việc
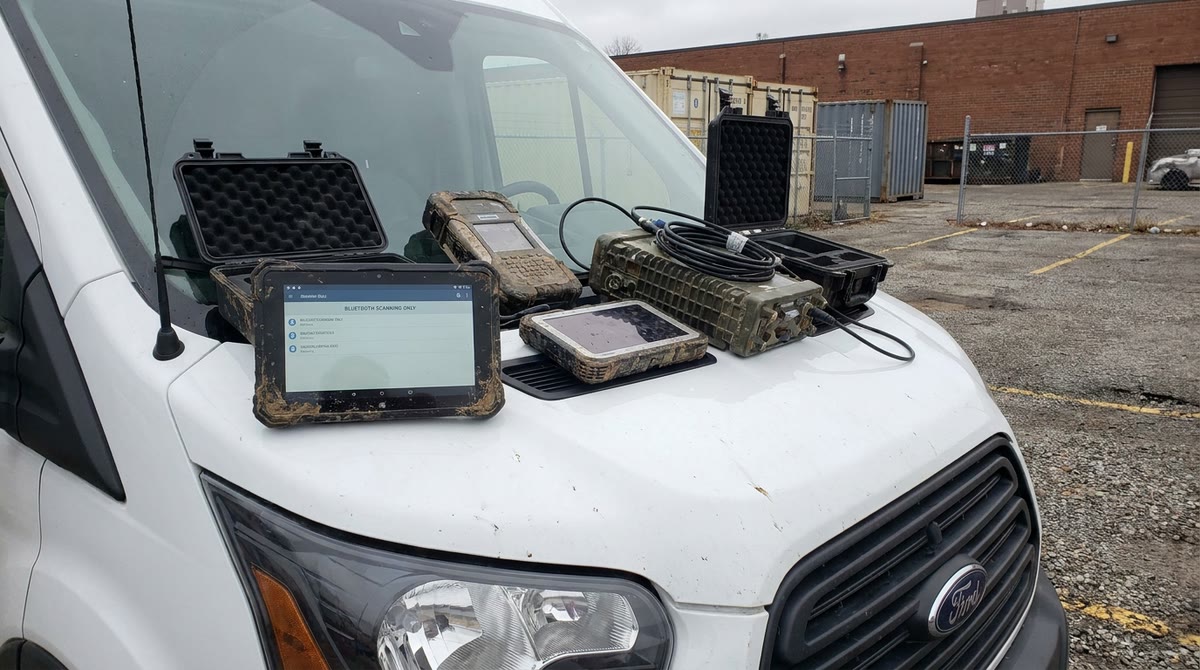
Một bài đăng của Simonas mô tả việc dùng cùng một nhiệm vụ xây dashboard network scanner để thử Opus 5.5, Astra 6, MiMo V2.6 Flash, Muse Spark 1.3 và GPT-6 Luna. Người viết cho biết GPT-6 Luna chỉ tạo scanner Bluetooth, trong khi các model còn lại xử lý thêm Wi-Fi và LAN; đây là trải nghiệm cá nhân, không phải benchmark được kiểm soát độc lập (nguồn trải nghiệm tác vụ).
Ở hướng khác, một bài đăng của Token Gremlin đọc các phản hồi mơ hồ từ nhân sự OpenAI như tín hiệu rằng DevDay có thể xuất hiện câu trả lời cho Opus 5.5, thậm chí nêu khả năng GPT-6.1 Astra. Chính bài đăng cũng ghi rõ chưa xác nhận nội bộ. Hai mẩu thông tin đặt ra cùng một vấn đề cho người mua: model nào được nhắc nhiều chưa chắc là model tạo ra đầu ra phù hợp nhất (nguồn về suy đoán DevDay).
Opus 5.5 trong bộ nguồn — phần nào đội marketing kiểm tra được
Bộ tư liệu không có tài liệu kỹ thuật chính thức, bảng giá, benchmark độc lập hoặc thông báo sản phẩm từ hãng. Vì vậy, chưa có “thứ đã đổi” đủ điều kiện để đưa vào nhóm cập nhật đã kiểm chứng. Điều có thể ghi nhận là Opus 5.5 xuất hiện như mốc so sánh trong một bài thử tác vụ và như đối thủ được cộng đồng dùng để suy đoán phản ứng tiếp theo của OpenAI.
Quyền mặc cả model AI nằm ở chi phí sai và khả năng hoàn tất việc
Đầu ra sai mục tiêu: lý do bài test riêng đáng giá hơn danh tiếng
Danh tiếng chỉ giúp một model được đưa vào vòng thử đầu tiên. Nó không trả lời được model có hiểu đúng phạm vi công việc hay không. Trải nghiệm với network scanner cho thấy một sai lệch nhỏ trong yêu cầu — chỉ làm scanner Bluetooth thay vì bao phủ Wi-Fi, Bluetooth và LAN — có thể khiến đầu ra không dùng được cho mục tiêu ban đầu. Trong cùng bài đăng, người viết cũng so sánh nhiều model trên một nhiệm vụ giống nhau; còn bài của Token Gremlin cho thấy sự chú ý của cộng đồng đang xoay quanh việc một model có câu trả lời đủ mạnh cho Opus 5.5 hay không (bài thử network scanner; thảo luận về khả năng đáp trả Opus 5.5).
Với marketing, bài test nên chấm đúng phần gây thiệt hại: brief bị hiểu sai, trường dữ liệu bị bỏ, format không đúng, số lần sửa và thời gian người thật phải kiểm tra. Khi các điểm này được ghi lại, đội mua công cụ có cơ sở thương lượng hơn thay vì dựa vào thứ hạng hoặc cảm nhận trên mạng.
Giới hạn sử dụng: yếu tố làm thay đổi giá trị của model đắt
Một model cho kết quả tốt nhưng giới hạn thấp, giá cao hoặc cần nhiều lần sửa vẫn có thể kém phù hợp với quy trình hằng ngày. Simonas đặt vấn đề về việc dùng model cấp thấp hơn cho người dùng trả phí khi model tốt hơn bị xem là quá đắt; đây là quan điểm của một người dùng, nhưng nó chỉ ra câu hỏi mua hàng cần đặt ra. Token Gremlin cũng chỉ phỏng đoán về một model mới và chưa xác nhận khả năng thực tế của nó (ý kiến người dùng về giới hạn và gói thuê bao; phỏng đoán về GPT-6.1 Astra).
Quyền mặc cả vì thế không chỉ đến từ việc chọn model có điểm cao. Người mua có thể yêu cầu thử trên dữ liệu thật, ghi rõ số lượt chạy, thời gian chờ, số lần sửa và mức độ cần người duyệt. Đây là những khoản chi và công việc mà bảng giới thiệu sản phẩm thường không thể hiện đầy đủ.
Dự đoán GPT-6.1 Astra chưa được xác nhận: người mua nên tin đến đâu?
GPT-6.1 Astra có phải câu trả lời cho Opus 5.5 không?
Đang lan truyền một phỏng đoán rằng OpenAI có thể giới thiệu GPT-6.1 Astra tại DevDay. Người đưa ra nhận định là Token Gremlin, dựa trên emoji, phản hồi mơ hồ và thời điểm tương tác; bài đăng tự nhận chưa thể xác nhận nội bộ. Đây là suy đoán cá nhân, không phải thông báo của OpenAI.
Điều dùng được: đội marketing chỉ nên lập hai kịch bản: tiếp tục model hiện tại nếu đầu ra đạt ngưỡng, hoặc thử model mới khi có quyền truy cập và tài liệu rõ ràng. Hãy chuẩn bị cùng một bộ prompt, dữ liệu mẫu và tiêu chí chấm để so sánh; không đổi công cụ trước khi có kết quả.
GPT-6 Luna có thật sự không phù hợp cho công việc hằng ngày?
Một người dùng kể rằng GPT-6 Luna thất bại trong một lần xây dashboard network scanner và cho rằng GPT-6 Sol có thể là bước lùi so với phiên bản trước. Đây là lời kể từ một lần thử, không đủ để kết luận chất lượng tổng thể của model hay đại diện cho mọi tài khoản. Bài đăng về Opus 5.5 cũng chỉ phản ánh kỳ vọng cộng đồng, chưa phải phép đo độc lập.
Điều dùng được: hãy lặp lại bài test ít nhất trên các nhóm việc đội đang làm, gồm viết brief, phân loại tệp khách, tạo bảng dữ liệu và kiểm tra nội dung. Ghi cả trường hợp model làm đúng để tránh quyết định chỉ từ một lỗi nổi bật.
Marketer Việt và model AI mới: dữ liệu tiếng Việt phải đứng trong bài test
Đội marketing Việt không nên bê nguyên kết quả từ một tác vụ tiếng Anh sang quy trình của mình. Một model có thể viết tốt nhưng xử lý kém tên sản phẩm, cách gọi địa phương, quy tắc giá, dữ liệu CRM hoặc format báo cáo nội bộ. Các nguồn hiện chỉ cho thấy sự khác biệt ở một nhiệm vụ kỹ thuật và kỳ vọng về các model mới; chúng không cung cấp bằng chứng cho năng lực tiếng Việt.
Cách thiết thực là tạo bộ test nhỏ từ dữ liệu đã ẩn thông tin riêng tư. Mỗi model xử lý cùng một brief, cùng cấu trúc đầu ra và cùng giới hạn thời gian. Người chấm ghi lỗi nội dung, lỗi format, số lần sửa và phần cần kiểm tra thủ công. Kết quả này giúp doanh nghiệp Việt mua đúng công cụ cho từng việc, thay vì mua theo tên model đang được nhắc đến.
Chấm điểm model AI bằng đầu ra trước khi đổi công cụ
- Chọn 3–5 tác vụ marketing lặp lại và viết tiêu chí đạt trước khi cho model chạy.
- Kiểm thử bằng dữ liệu tiếng Việt đã ẩn thông tin nhạy cảm; ghi riêng lỗi hiểu brief và lỗi format.
- So sánh tổng thời gian hoàn tất, số lần sửa, giới hạn sử dụng và chi phí thuê bao thay vì chỉ nhìn chất lượng câu trả lời đầu tiên.
- Chỉ mở rộng model sau khi người phụ trách nghiệp vụ duyệt kết quả và có phương án quay lại công cụ cũ.
Xem thêm phân tích & hướng dẫn marketing tại https://marketing365.vn.
Theo dõi thêm các bài phân tích từ Marketing365 để cập nhật xu hướng marketing mới nhất.
Đọc thêm các bài cùng chuyên mục Động thái AI.
Nguồn tham khảo
- A few OpenAI employees have been replying to posts suggesting that Opus 5.5 caught them off guard
- I’ve been a Luna hater since the launch of GPT-5.6 Luna