Nội dung
- Dấu vết model AI đang chuyển trọng tâm từ tính năng sang khả năng kiểm soát
- Changelog và prompt đang chạm tới việc dùng model AI hằng ngày
- Ràng buộc kỹ thuật quyết định model AI có vào được quy trình hay không
- Lời đồn về quảng cáo ChatGPT và Nano Banana chưa có xác nhận độc lập
- Dữ liệu Việt cho model AI cần điểm kiểm soát trước khi mở rộng
- Kiểm thử model AI bằng quy trình thật trước khi tăng ngân sách
- Nguồn tham khảo
Model AI mới không tự tạo ra giá trị marketing chỉ vì có thêm tính năng. Những dấu hiệu quanh ChatGPT, Nano Banana, Grok và Claude cho thấy giá trị đang phụ thuộc nhiều hơn vào việc đội ngũ có biết model nào đang chạy, thay đổi ra sao và đầu ra được kiểm tra ở đâu. Với marketer Việt Nam, đây là vấn đề về quy trình, dữ liệu và ngân sách chứ không chỉ là chuyện chọn công cụ.
Điểm chính
- Model đổi tên, đổi phiên bản hoặc đổi cấu hình có thể làm benchmark và quy trình kiểm thử mất ý nghĩa.
- Changelog, prompt chuẩn, connector và điểm duyệt là các điều kiện để đưa AI vào công việc thật.
- Các thông tin về quảng cáo trong ChatGPT và Nano Banana 2.5 cần được xem là chưa xác nhận độc lập.
- Đội marketing Việt nên thử model trên một quy trình có dữ liệu tiếng Việt và tiêu chí duyệt rõ ràng trước khi tăng ngân sách.
Dấu vết model AI đang chuyển trọng tâm từ tính năng sang khả năng kiểm soát
Các nguồn được cung cấp mô tả một thị trường model AI thay đổi ở nhiều lớp. Một bài đăng trên X nêu khả năng OpenAI đưa quảng cáo dạng hình ảnh vào cuộc trò chuyện ChatGPT, trong khi một chuỗi bài khác ghi lại quá trình đổi tên và đổi cấu hình của Nano Banana qua nhiều mã model khác nhau (Indian Tech & Infra; lyra). Hai thông tin này chưa đủ để kết luận về sản phẩm thương mại, nhưng chúng chỉ ra một khó khăn thật: marketer có thể phải làm việc với công cụ mà tên gọi và khả năng chưa ổn định.
Ở chiều ngược lại, Grok được mô tả là có changelog công khai cho 46 bản phát hành, còn tài liệu hướng dẫn Claude gom prompt, Projects, Artifacts, connector và Claude Code vào cùng một cách làm việc (tetsuoai; Jara). Điểm chung của bốn diễn biến là model chỉ có giá trị vận hành khi người dùng theo dõi được thay đổi và nối nó vào một quy trình có thể kiểm tra.
Changelog và prompt đang chạm tới việc dùng model AI hằng ngày
Khối này chỉ ghi nhận những thứ nguồn mô tả trực tiếp. Chúng chưa phải bằng chứng cho hiệu quả kinh doanh của từng công cụ, nhưng có thể cho thấy đội marketing cần chuẩn bị loại năng lực nào.
Changelog Grok: đội marketing có thể theo dõi thay đổi thay vì đoán
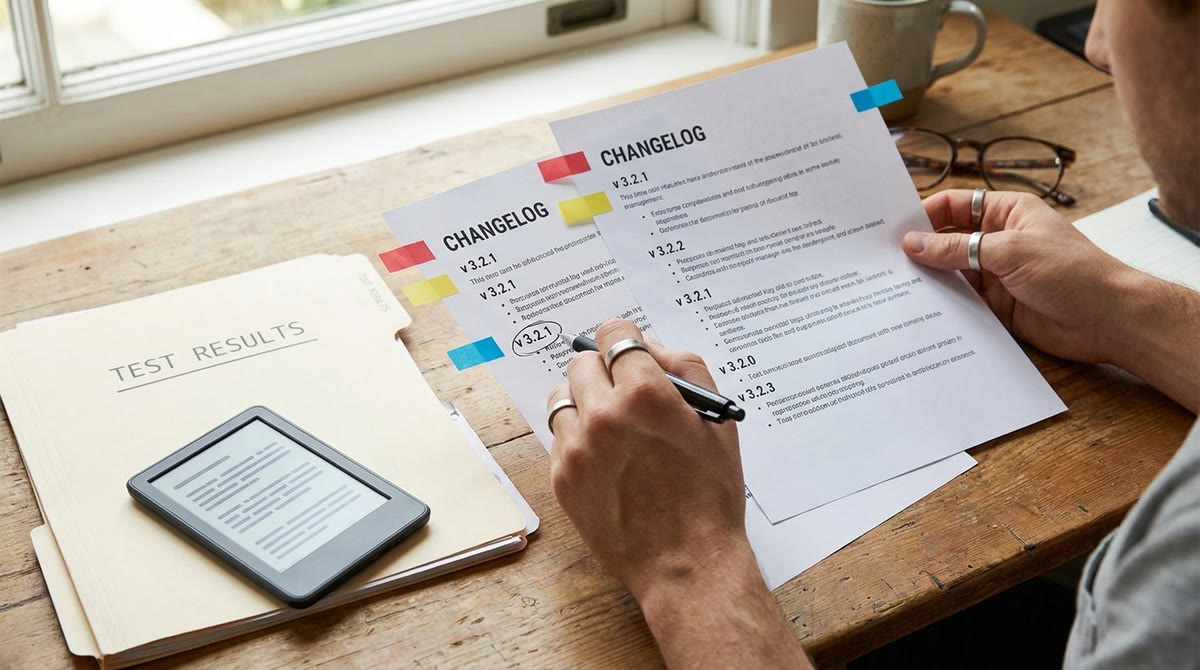
Changelog công khai được mô tả là ghi lại 46 bản phát hành của Grok Bot, gồm phần mới, phần được cải thiện và lỗi được sửa. RSS đi kèm cho phép theo dõi bằng phần mềm (nguồn tetsuoai). Với marketing, giá trị nằm ở khả năng đối chiếu thời điểm thay đổi với chất lượng đầu ra, tỷ lệ lỗi và chi phí kiểm tra. Đội ngũ có thể lưu version, prompt và kết quả vào một bảng theo dõi thay vì đánh giá bằng cảm nhận.
Claude cheat sheet: prompt và connector trở thành kỹ năng vận hành
Tài liệu được chia sẻ về Claude bao gồm cách chọn model, prompt theo vai trò và nhiệm vụ, đầu ra có cấu trúc, Projects, Artifacts, MCP, connector và Claude Code (nguồn Jara). Điều này chạm tới các việc như nghiên cứu, viết nội dung, phân tích và xử lý code. Marketer cần tách phần nào do AI tạo, phần nào lấy từ dữ liệu nội bộ và phần nào bắt buộc người phụ trách duyệt, nhất là khi connector cho phép công cụ tiếp cận dịch vụ bên ngoài.
Ràng buộc kỹ thuật quyết định model AI có vào được quy trình hay không
Phiên bản đổi tên làm đứt benchmark và tăng việc kiểm thử
Chuỗi thông tin về Nano Banana mô tả một checkpoint đi qua các tên instant-ramen, instant-ramen-v2, spicy-mayo rồi được đối tác truy cập dưới model ID nano-banana-2.5; cùng chuỗi đó còn nêu các mức thinking và kích thước ảnh khác nhau (lyra). Khi tên, mã và cấu hình thay đổi, một benchmark cũ không còn tự động đại diện cho phiên bản mới. Changelog của Grok cho thấy cách giải quyết có thể là ghi lại từng bản phát hành và phần thay đổi (tetsuoai). Đây là ràng buộc kỹ thuật có tác động trực tiếp tới ngân sách: mỗi thay đổi cần một vòng thử lại với các prompt quan trọng.
Prompt, connector và điểm duyệt tạo thành hàng rào dữ liệu
Cheat sheet về Claude xem prompt theo vai trò, ví dụ mẫu, đầu ra có cấu trúc, Projects và connector là các thành phần của một workflow (Jara). Nếu một công cụ có thể lấy dữ liệu từ dịch vụ ngoài, câu hỏi không chỉ là model viết hay đến đâu mà còn là dữ liệu nào được gửi đi, ai được truy cập và ai duyệt đầu ra. Khả năng cập nhật theo changelog của Grok cung cấp thêm một cách quản lý: mỗi lần thay đổi phải được gắn với kiểm thử quyền truy cập, định dạng đầu ra và kết quả cuối (tetsuoai).
Lời đồn về quảng cáo ChatGPT và Nano Banana chưa có xác nhận độc lập
Quảng cáo hình ảnh trong ChatGPT có phải điểm chạm mới của thương hiệu?
Một tài khoản trên X nói OpenAI đang đưa quảng cáo hình ảnh vào các cuộc trò chuyện ChatGPT (Indian Tech & Infra). Đây là lời đăng từ bên thứ ba; trong dữ liệu được cung cấp không có xác nhận chính thức của OpenAI, nên chưa thể xem đó là tính năng đã triển khai rộng.
Điều dùng được: marketer có thể lập sẵn giả thuyết đo lường cho một điểm chạm trong giao diện hội thoại, nhưng chưa nên chuyển ngân sách. Hãy xác định trước tiêu chí về ngữ cảnh hiển thị, quyền riêng tư, brand safety và cách tách hiệu quả quảng cáo khỏi ảnh hưởng của câu trả lời AI.
Nano Banana 2.5 đã sẵn sàng cho chiến dịch hình ảnh chưa?
Chuỗi bài của lyra dự đoán Nano Banana 2.5, được gọi là spicy-mayo và có model ID nano-banana-2.5, sẽ được phát hành sau khi đối tác truy cập qua Vertex; bài cũng nêu các mức thinking và kích thước ảnh (lyra). Đây là lời kể và dự đoán cá nhân, không phải thông báo phát hành chính thức trong dữ liệu này.
Điều dùng được: đội sáng tạo chỉ nên thử bằng một bộ brief cố định, lưu prompt, ảnh đầu ra và tiêu chí duyệt. Không dùng tên model hoặc lời hứa về kích thước ảnh làm căn cứ duy nhất để cam kết tiến độ với khách hàng.
Dữ liệu Việt cho model AI cần điểm kiểm soát trước khi mở rộng
Ở Việt Nam, rào cản đầu tiên thường không phải thiếu thêm một model. Đó là dữ liệu tiếng Việt chưa đồng nhất, brief thay đổi theo người viết và thiếu người chịu trách nhiệm duyệt. Cách làm với Claude trong tài liệu được chia sẻ gợi ý việc đóng gói vai trò, nhiệm vụ và định dạng đầu ra; còn câu chuyện phiên bản Nano Banana cho thấy bộ kiểm thử phải gắn với mã model cụ thể (Jara; lyra).
Marketer Việt nên bắt đầu từ một quy trình hẹp như viết biến thể quảng cáo, tóm tắt phản hồi khách hàng hoặc tạo concept hình ảnh. Bộ dữ liệu thử cần có tiếng Việt đời thường, tên sản phẩm, quy định thương hiệu và những trường hợp dễ gây hiểu sai. Changelog của Grok cho thấy việc ghi lại phiên bản có thể hỗ trợ kiểm tra kết quả theo thời gian (tetsuoai). Nếu không lưu các yếu tố này, đội ngũ không biết lỗi đến từ prompt, dữ liệu hay bản model.
Kiểm thử model AI bằng quy trình thật trước khi tăng ngân sách
- Chọn một quy trình marketing có đầu vào rõ, đầu ra cụ thể và một người duyệt cuối.
- Lưu model ID, version, prompt, dữ liệu gửi vào và kết quả để có thể cho ra kết quả giống nhau khi kiểm tra lại.
- Tạo benchmark tiếng Việt gồm cả mẫu đạt và mẫu sai; đo thời gian sửa, tỷ lệ được duyệt và chi phí cho mỗi đầu ra.
- Chỉ mở rộng khi changelog, quyền truy cập, connector và quy tắc dữ liệu đã được kiểm tra trên môi trường làm việc thật.
Xem thêm phân tích & hướng dẫn marketing tại https://marketing365.vn.
Theo dõi thêm các bài phân tích từ Marketing365 để cập nhật xu hướng marketing mới nhất.
Đọc thêm các bài cùng chuyên mục Động thái AI.
Nguồn tham khảo
- OpenAI is introducing a new image based ads in ChatGPT chats
- It took them a while because the whole process was a mess
- Grok Bot has a public changelog
- CLAUDE AI CHEAT SHEET — YOUR COMPLETE GUIDE TO USING CLAUDE LIKE A PRO!