Nội dung
- Cuộc đua model AI chuyển trọng tâm sang khả năng kiểm chứng
- Claude Projects và Haiku 5.5 — chạm tới cách đội marketing thử công cụ
- Chi phí và ràng buộc kỹ thuật quyết định model nào dùng được
- Carbon và Gemini 4 Argon chưa xác nhận: đừng gắn vào ngân sách
- Tiếng Việt và ngân sách API định hình cách chọn model
- Đặt bài test model AI trước khi mở rộng ngân sách
- Nguồn tham khảo
Cuộc đua model AI đang chuyển từ câu hỏi “model nào thông minh hơn?” sang “model nào chạy được trong công việc thật?”. Với marketer Việt Nam, khác biệt này liên quan trực tiếp đến ngân sách API, dữ liệu tiếng Việt, khả năng tích hợp và số bước con người phải kiểm tra trước khi nội dung được dùng.
Các diễn biến quanh Carbon, Gemini 4 Argon, Claude, Codex và những model được cộng đồng so sánh cho thấy điểm số không còn đủ để quyết định mua. Giá trị chỉ xuất hiện khi model chịu được workflow, giới hạn hạ tầng và yêu cầu giải trình của doanh nghiệp.
Điểm chính
- Tốc độ phát hành làm tuổi thọ của bảng so sánh model ngắn hơn.
- Chi phí và khả năng tích hợp có thể đảo ngược lựa chọn dựa trên điểm benchmark.
- Tính năng agent mở rộng việc AI có thể làm, đồng thời tăng số điểm cần kiểm tra.
- Marketer Việt nên thử model trên workflow tiếng Việt hẹp trước khi mở rộng ngân sách.
Cuộc đua model AI chuyển trọng tâm sang khả năng kiểm chứng
Các bài đăng được sử dụng trong bài này cho thấy thị trường đang nhìn model AI như một sản phẩm thay đổi liên tục, không phải một công cụ có chất lượng cố định. Bindu Reddy cho rằng nhân sự Google đánh giá Carbon nội bộ rất cao, thậm chí có thể hơn Gemini Pro 4 Argon chưa phát hành; bài đăng cũng đặt Carbon vào cuộc đua thời điểm với Fable 5.5 và Astra 6.5. Đây là nhận định cá nhân, chưa phải công bố chính thức của Google.
Ở một hướng khác, Riley Brown liệt kê loạt thay đổi quanh Claude, Codex, ChatGPT, GrokBot và các sản phẩm agent. Token Gremlin lại đặt câu hỏi về khả năng OpenAI tạo ra model tốt hơn Fable 5.5, đồng thời cho rằng mức giá của Astra khiến model này khó tiếp cận người dùng phổ thông. Những mảnh ghép này cùng chỉ về một vấn đề: model tốt trên giấy chưa chắc là model phù hợp với công việc cần chạy đều, có kiểm tra và nằm trong ngân sách.
Claude Projects và Haiku 5.5 — chạm tới cách đội marketing thử công cụ
Khối này chỉ giữ những mục được nêu như cập nhật sản phẩm trong nguồn tổng hợp của Riley Brown. Vì tư liệu không cung cấp bảng giá, benchmark hay tài liệu kỹ thuật chi tiết, người đọc không nên xem các mục dưới đây là kết luận về chất lượng model.
Claude Projects: gom ngữ cảnh để đội nội dung thử workflow
Claude Projects được liệt kê như một phần cập nhật của Claude trong bài tổng hợp của Riley Brown. Về mặt công việc, một không gian Projects có thể giúp đội nội dung gom tài liệu, hướng dẫn thương hiệu và yêu cầu đầu ra vào cùng một nơi để thử. Marketer vẫn cần kiểm tra cách công cụ giữ ngữ cảnh, giới hạn dữ liệu được đưa vào và quyền truy cập của từng thành viên trước khi đặt tài liệu khách hàng vào đó.
Haiku 5.5: bài toán tốc độ phải gắn với chi phí mỗi lượt chạy
Haiku 5.5 được nguồn của Riley Brown nêu như một model đã phát hành. Với đội marketing, một model thiên về tốc độ chỉ có ý nghĩa khi xử lý được các việc lặp lại như phân loại phản hồi, tạo biến thể tiêu đề hoặc tóm tắt brief mà vẫn giữ đúng yêu cầu. Cách kiểm tra phù hợp là ghi lại thời gian xử lý, tỷ lệ phải sửa và tổng chi phí cho một đầu ra dùng được, thay vì chỉ nhìn tên model.
Giao diện thông minh của ChatGPT: thêm bước kiểm tra cho quy trình nhiều công cụ
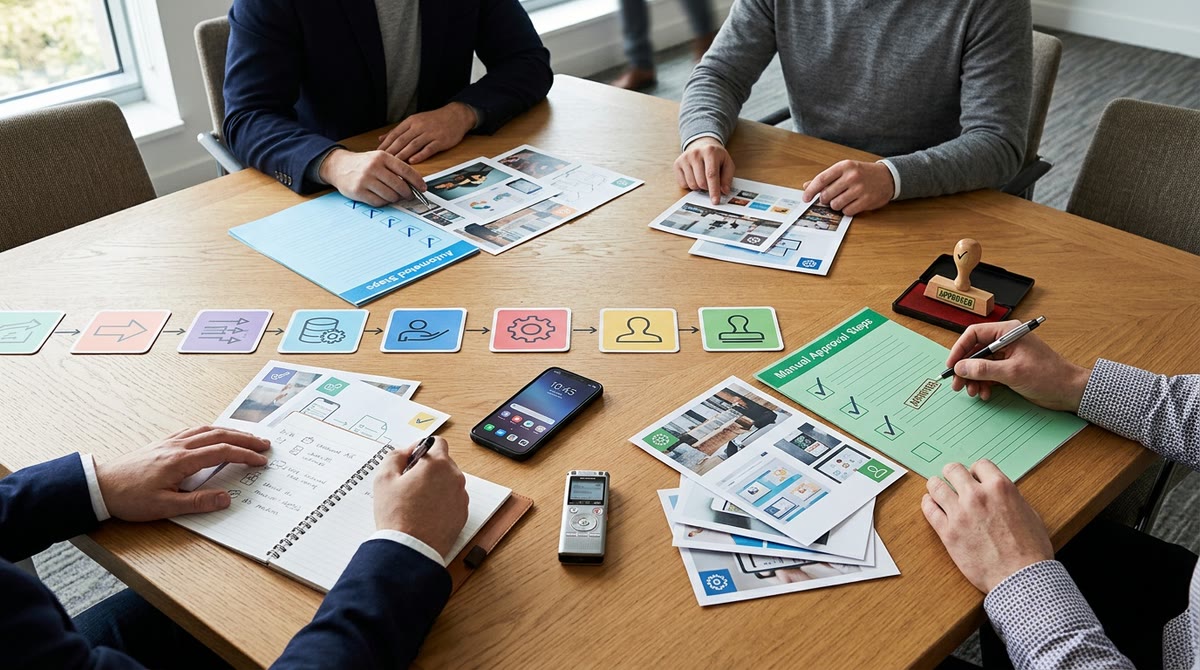
“ChatGPT Intelligent UI” nằm trong danh sách cập nhật của nguồn Riley Brown. Giao diện có thể giúp người dùng thao tác với nhiều loại đầu ra thuận tiện hơn, nhưng cũng làm tăng nguy cơ đội ngũ tưởng rằng phần việc đã hoàn tất khi dữ liệu, logic hoặc kết quả cuối vẫn cần người xem. Do đó, brief nên ghi rõ điểm nào được tự động hóa và điểm nào phải có người duyệt.
Chi phí và ràng buộc kỹ thuật quyết định model nào dùng được
Ngân sách API thay đổi khi model không chỉ trả lời mà còn chạy việc
Riley Brown mô tả một tuần có nhiều cập nhật về agent, từ Claude và Codex đến GrokBot; Token Gremlin lại nhận xét Astra có năng lực tốt nhưng chi phí khiến người dùng thông thường khó tiếp cận. Hai nguồn này cho thấy chi phí không chỉ nằm ở một câu trả lời. Khi model tham gia nhiều bước, tổng tiền còn phụ thuộc số lần gọi, lượng dữ liệu gửi đi, số lần chạy lại và phần việc con người phải sửa.
Vì vậy, bài test nên tính trên “đầu ra đạt chuẩn”, không phải số lượt prompt. Một model rẻ nhưng tạo nhiều lỗi có thể tốn hơn model đắt nếu đội ngũ phải đọc lại, sửa và chạy lại toàn bộ quy trình.
Khả năng nối vào workflow giới hạn giá trị của điểm benchmark
Quan điểm của Selta cho rằng OpenAI phát triển AI theo hướng công cụ, Anthropic để ngỏ khả năng AI có vai trò rộng hơn, còn Gemini được nhìn nhận là xây dựng theo cách giàu tính con người hơn. Riley Brown đồng thời mô tả sự mở rộng của agent và giao diện AI. Hai nguồn không chứng minh model nào tốt nhất, nhưng làm rõ một ràng buộc kỹ thuật: cùng một năng lực sẽ cho giá trị khác nhau tùy cách nối với dữ liệu, ứng dụng và quyền cho máy tự làm tới đâu.
Marketer cần hỏi model có đọc đúng dữ liệu từ CRM, bảng tính, kho nội dung hay không; có ghi lại lịch sử thao tác hay không; và có thể dừng trước bước gửi khách hàng hay không. Nếu chưa trả lời được ba câu hỏi này, điểm benchmark chỉ là tín hiệu tham khảo.
Tốc độ phát hành rút ngắn thời gian sử dụng của bảng so sánh
Nhận định về Carbon và Gemini 4 Argon của Bindu Reddy đặt việc chưa phát hành cạnh những model được nhắc tới trong bài của Token Gremlin như Fable 5.5, Opus 5.5 và Astra. Khi các tên model liên tục được đem ra so sánh, bảng đánh giá nội bộ dễ lỗi thời trước khi đội mua hoàn tất quy trình. Cách xử lý thiết thực là giữ bộ kiểm thử cố định theo nhiệm vụ, để có thể so sánh model mới với model đang dùng mà không đổi tiêu chí theo cảm giác.
Carbon và Gemini 4 Argon chưa xác nhận: đừng gắn vào ngân sách
Liệu Carbon có đủ căn cứ để thay model đang dùng?
Đang lan truyền nhận định từ Bindu Reddy rằng nhân sự Google đánh giá Carbon rất cao và Carbon có thể hơn Gemini Pro 4 Argon, dù các model này chưa được xác nhận theo dữ liệu được cung cấp. Đây là lời kể và đánh giá cá nhân trên X, không phải thông báo chính thức của Google.
Điều dùng được: đội marketing chỉ nên ghi Carbon vào danh sách theo dõi. Hãy giữ model hiện tại cho workflow đang chạy, chuẩn bị cùng một bộ prompt và dữ liệu kiểm thử, rồi chỉ đổi khi có tài liệu chính thức, quyền truy cập rõ ràng và kết quả đo được.
Fable 5.5 và Astra có phải mốc mới để đổi công cụ?
Token Gremlin dự đoán về các model vượt Fable 5.5 và so sánh chúng với Opus 5.5, đồng thời nêu nhận xét cá nhân về chi phí của Astra. Đây là phỏng đoán và trải nghiệm được chia sẻ bởi một tài khoản cá nhân; nguồn không xác nhận bảng giá, benchmark hay kế hoạch phát hành từ các hãng.
Điều dùng được: marketer không nên đưa các tên này vào cam kết ngân sách hoặc lịch triển khai. Có thể lập bảng chờ gồm giá, giới hạn API, khả năng xử lý tiếng Việt, bảo mật dữ liệu và cách xuất log; chỉ quyết định sau khi các mục đó có nguồn chính thức.
Tiếng Việt và ngân sách API định hình cách chọn model
Ở Việt Nam, một model có điểm cao nhưng xử lý kém tiếng Việt, tên riêng địa phương, cách viết thương hiệu hoặc dữ liệu không dấu sẽ tạo thêm chi phí sửa. Đội marketing nên chọn một workflow hẹp như phân loại phản hồi khách hàng, viết biến thể quảng cáo hoặc tóm tắt cuộc gọi. Bộ thử cần có dữ liệu đã ẩn thông tin cá nhân, tiêu chí chấm rõ và mẫu đầu ra do người phụ trách thương hiệu duyệt.
Ngân sách cũng cần tính cả phần tích hợp. Nếu model phải gọi nhiều công cụ, đọc nhiều tài liệu hoặc chạy lại vì lỗi định dạng, số tiền thực tế sẽ khác xa giá của một prompt đơn lẻ. Với doanh nghiệp nhỏ, bắt đầu bằng model dễ kiểm soát và một điểm duyệt rõ thường an toàn hơn việc chạy theo model được cộng đồng khen nhưng chưa có tài liệu đủ dùng.
Đặt bài test model AI trước khi mở rộng ngân sách
- Chọn một workflow có đầu ra đo được, chẳng hạn tỷ lệ phân loại đúng hoặc số bản quảng cáo đạt chuẩn.
- Chạy cùng một bộ dữ liệu tiếng Việt trên model hiện tại và model mới; ghi lại lỗi, số lần sửa và thời gian xử lý.
- Tính tổng chi phí gồm API, công cụ kết nối, lượt chạy lại và giờ công kiểm tra.
- Chỉ mở rộng sau khi xác định rõ dữ liệu nào được gửi, máy được tự làm tới đâu và ai chịu trách nhiệm duyệt đầu ra.
Xem thêm phân tích & hướng dẫn marketing tại https://marketing365.vn.
Theo dõi thêm các bài phân tích từ Marketing365 để cập nhật xu hướng marketing mới nhất.
Đọc thêm các bài cùng chuyên mục Động thái AI.
Nguồn tham khảo
- Google’s employees think that their internal model Carbon is very good — Bindu Reddy
- Massive week in the world of agents. New Updates to Claude, GrokBot & Codex — Riley Brown
- Honestly, I’m curious to see OpenAI release a model better than Fable 5.5 — Token Gremlin
- To be honest, OpenAI and Anthropic are heading in completely different directions right now — Selta