Nội dung
- Hạ tầng AI và chip tăng tốc: bối cảnh của cuộc đua hiệu suất
- Những thứ đã đổi trong hạ tầng AI — chạm tới cách đội marketing mua công cụ
- Chi phí suy luận, thời gian máy dừng và điện năng làm lệch quyền mặc cả
- Hạ tầng AI tại Việt Nam: khoảng cách quy mô không xoá được quyền chọn
- Chốt cách mua hạ tầng AI trước khi mở rộng ngân sách marketing
- Nguồn tham khảo
Hạ tầng AI đang chuyển từ cuộc đua mua chip sang cuộc đua khai thác chip hiệu quả. Với marketer Việt Nam, thay đổi này ảnh hưởng trực tiếp đến giá công cụ, tốc độ thử nghiệm nội dung và khả năng mở rộng các quy trình dùng model.
Luận điểm của bài viết là quyền mặc cả đang nghiêng dần về phía người mua có dữ liệu vận hành tốt: họ không chỉ hỏi model nào mạnh, mà còn hỏi tốc độ thực tế, số giờ máy hoạt động, mức tiêu thụ điện và khả năng đổi nhà cung cấp.
Điểm chính
- Hiệu suất suy luận phải được đo trên tác vụ và phần cứng cụ thể, không chỉ qua điểm benchmark.
- Độ bền của cụm GPU có thể quyết định chi phí thật của một chiến dịch AI quy mô lớn.
- Điện năng và khả năng giảm tải theo nhu cầu lưới điện sẽ trở thành điều kiện mua hạ tầng.
- Đội marketing Việt nên mua theo đầu ra và mức phục vụ, thay vì chỉ mua lượt gọi model.
Hạ tầng AI và chip tăng tốc: bối cảnh của cuộc đua hiệu suất
Sáu diễn biến trong dữ liệu nguồn cùng chỉ về một hướng: giá trị của hạ tầng AI nằm ở việc biến năng lực tính toán thành đầu ra ổn định. EAGLE-4 được giới thiệu với mức 961,6 token/giây trên Qwen3.8-27B, dùng BF16, bốn GPU NVIDIA B300, TP4 và một request ở T=0; đây là một phép đo gắn với cấu hình cụ thể, không phải lời hứa chung cho mọi hệ thống (nguồn EAGLE-4). DeepSeek cũng công khai DeepInfer, framework suy luận dùng cho DeepSeek-V4.1-Flash, với mục tiêu tăng throughput, giảm latency, compute và điện năng (nguồn DeepSeek).
Ở quy mô lớn hơn, Meta cho biết siêu cụm Prometheus có hàng trăm nghìn GPU và đạt hơn 85% goodput khi pretraining, hơn 90% khi reinforcement learning; thời gian trung bình giữa các lần gián đoạn trong quá trình huấn luyện Muse Wonder khoảng 47.000 giờ GPU (nguồn AI at Meta). NVIDIA đồng thời đặt hạ tầng AI trong bài toán công nghiệp châu Âu và khả năng điều chỉnh tải khi lưới điện cần giảm áp lực (nguồn NVIDIA về Đức; nguồn NVIDIA về lưới điện).
Những thứ đã đổi trong hạ tầng AI — chạm tới cách đội marketing mua công cụ
Khối cập nhật dưới đây chỉ ghi nhận các công cụ, chỉ số và năng lực đã được nêu rõ trong nguồn. Giá trị với marketing nằm ở việc chúng mở thêm cơ sở để so sánh nhà cung cấp.
EAGLE-4: đo tốc độ suy luận theo đúng cấu hình cần dùng
EAGLE-4 là bản phát triển tiếp theo của dòng EAGLE, hướng tới tăng tốc inference. Con số 961,6 token/giây trên Qwen3.8-27B được gắn với bốn NVIDIA B300, BF16, TP4, một request và T=0. Đội marketing có thể dùng cách công bố này làm mẫu khi yêu cầu vendor ghi rõ model, GPU, batch, số request đồng thời và latency, thay vì chỉ nhận một con số tốc độ chung (nguồn EAGLE-4).
DeepInfer: đưa chi phí suy luận vào tiêu chí chọn nền tảng
DeepInfer là framework inference do DeepSeek mở mã nguồn, được mô tả là phục vụ DeepSeek-V4.1-Flash ở quy mô lớn với throughput cao và latency thấp. Nó còn nhắm tới việc giảm compute và điện năng. Với đội marketing, thay đổi cần làm là yêu cầu báo giá theo tác vụ hoàn tất, đồng thời kiểm tra khả năng chạy trên hạ tầng khác để tránh phụ thuộc một lựa chọn duy nhất (nguồn DeepSeek).
Prometheus: biến goodput thành chỉ số của ngân sách AI
Prometheus là siêu cụm GPU Meta dùng để huấn luyện các model Muse. Meta công bố các mức goodput trên 85% cho pretraining, trên 90% cho reinforcement learning và khoảng 47.000 giờ GPU là thời gian trung bình giữa các lần gián đoạn trong quá trình huấn luyện Muse Wonder. Marketer không cần tự vận hành siêu cụm, nhưng nên hỏi nền tảng AI về thời gian gián đoạn, cách bù SLA và số lần chạy lại khi xây kế hoạch ngân sách (nguồn AI at Meta).
Chi phí suy luận, thời gian máy dừng và điện năng làm lệch quyền mặc cả
Giá mỗi token không còn đủ để so sánh công cụ AI
DeepInfer cho thấy chi phí inference gắn với cả throughput, latency, compute và điện năng. EAGLE-4 lại cho thấy tốc độ chỉ có ý nghĩa khi đi cùng model, GPU và cách chạy cụ thể. Hai dữ liệu này làm thay đổi cách mua: bên mua có thể yêu cầu bảng so sánh chi phí trên một brief, một biến thể nội dung hoặc một lần chấm điểm tệp khách hàng, thay vì so giá token đơn lẻ.
Đây là dịch chuyển quyền mặc cả có lợi cho người mua có dữ liệu. Khi marketer biết một tác vụ cần bao nhiêu token, bao lâu mới xong và tỷ lệ lỗi là bao nhiêu, họ có thể chuyển giữa model hoặc nhà cung cấp mà không tranh luận bằng cảm giác.
Goodput thấp biến hóa đơn GPU thành chi phí thời gian
Meta đặt goodput và thời gian giữa các lần gián đoạn vào trung tâm của câu chuyện vận hành. NVIDIA lại mô tả AI factory cần điều chỉnh công suất và chuyển workload khi lưới điện cần giảm tải. Hai góc này cho thấy tổng chi phí không chỉ là tiền thuê GPU: còn có thời gian chờ, lượt chạy lại, lịch phát hành bị trễ và năng lực phải giữ sẵn dù chưa dùng hết.
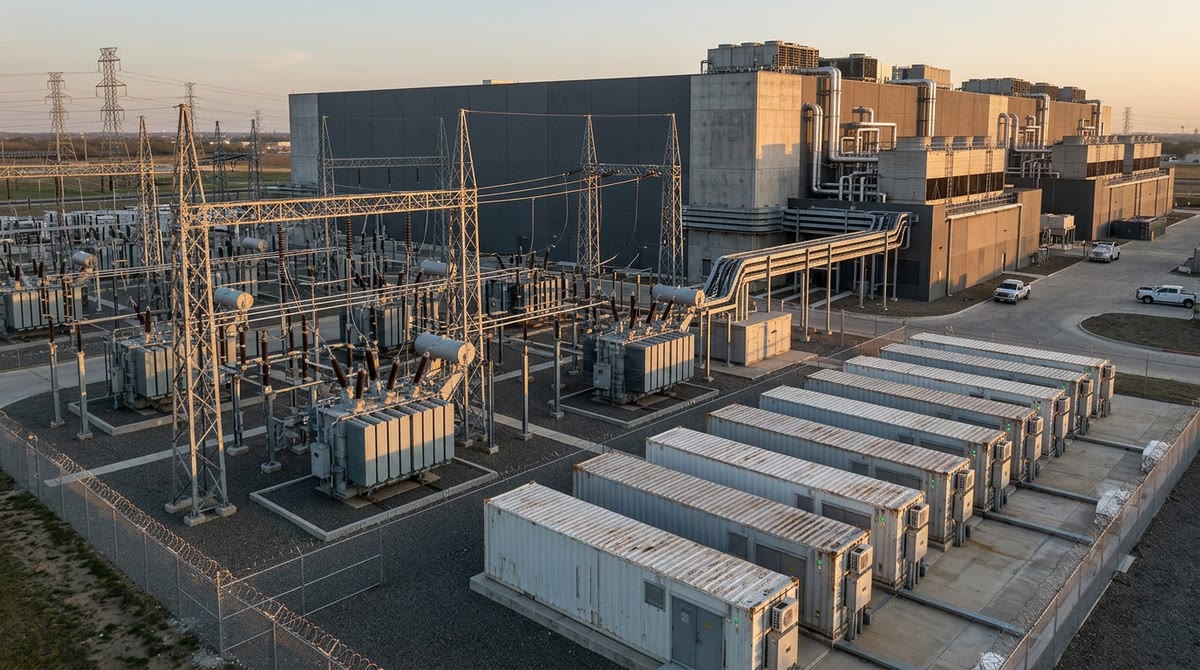
Với marketing, hệ quả là SLA phải ghi cả thời gian hoàn tất và cách xử lý khi hệ thống bị gián đoạn. Một công cụ rẻ hơn nhưng khiến đội phải chờ hoặc chạy lại nhiều lần có thể làm chi phí chiến dịch tăng.
Chip nhanh hơn chỉ tạo lợi thế khi điện và hạ tầng theo kịp
EAGLE-4 gắn kết quả với bốn B300, còn NVIDIA đưa bài toán điện lưới vào thiết kế AI factory. Khi workload AI lớn hơn, người mua không thể tách chip khỏi rack, làm mát, điện và khả năng chuyển tải. Các kế hoạch kết hợp AI với sản xuất, ô tô, robot và y tế tại Đức cũng cho thấy hạ tầng đang gắn với từng ngành sử dụng, không chỉ với phòng thí nghiệm (nguồn NVIDIA về công nghiệp Đức; nguồn NVIDIA về lưới điện).
Hạ tầng AI tại Việt Nam: khoảng cách quy mô không xoá được quyền chọn
Doanh nghiệp Việt khó có quy mô hàng trăm nghìn GPU như Prometheus. Tuy vậy, họ vẫn có thể hưởng lợi từ cùng một nguyên tắc: mua khả năng hoàn tất công việc, không mua danh sách phần cứng. DeepInfer và tiến trình EAGLE cho thấy phần mềm tối ưu inference có thể trở thành yếu tố cạnh tranh bên cạnh chip; điều này mở ra cơ hội cho nhà cung cấp trong nước xây dịch vụ tối ưu tiếng Việt, dữ liệu riêng và workload marketing.
NVIDIA nói về các AI factory có thể điều chỉnh tải để hỗ trợ lưới điện. Với doanh nghiệp Việt, bài học thiết thực hơn là chọn lịch chạy batch vào khung ít áp lực, giới hạn tác vụ không cần phản hồi tức thì và yêu cầu nhà cung cấp công khai SLA. Các đội có dữ liệu về latency, lỗi, thời gian chờ và số lượt chạy lại sẽ có vị thế đàm phán tốt hơn khi đổi công cụ.
Chốt cách mua hạ tầng AI trước khi mở rộng ngân sách marketing
- Lập bảng đo cho từng tác vụ: thời gian hoàn tất, lỗi, token, số lượt chạy lại và chi phí trên một đầu ra.
- Yêu cầu vendor ghi rõ model, GPU, batch, số request đồng thời và điều kiện đo tốc độ, theo cách nguồn EAGLE-4 đã nêu.
- Đưa goodput, thời gian gián đoạn và SLA vào hợp đồng, không chỉ ghi giá API hoặc giá thuê máy.
- Thử hai đường chạy cho cùng một workflow để giữ quyền đổi nhà cung cấp khi chi phí điện, GPU hoặc latency thay đổi; cách tiếp cận này phù hợp với mục tiêu giảm compute của DeepInfer và yêu cầu điều chỉnh tải mà NVIDIA nêu ra.
Xem thêm phân tích & hướng dẫn marketing tại https://marketing365.vn.
Theo dõi thêm các bài phân tích từ Marketing365 để cập nhật xu hướng marketing mới nhất.
Đọc thêm các bài cùng chuyên mục Động thái AI.
Nguồn tham khảo
- EAGLE-4 / Orikan (@GesoraMeshack)
- Introducing DeepInfer — DeepSeek
- AI at Meta: Prometheus and Muse Wonder
- NVIDIA: Germany and industrial AI
- NVIDIA: AI factories and grid relief