Nội dung
- Bối cảnh mô hình AI chuyển từ câu trả lời sang phần việc có công cụ
- Tính năng mô hình AI chạm tới phân bổ ngân sách marketing
- Nhiều agent song song: đội ngũ phải thiết kế điểm kiểm tra
- Dot xử lý sự cố: hoạt động trực ca cần tài liệu hóa quy trình
- Giọng nói cho GPT-Live-1: trải nghiệm audio cần thêm chi phí kiểm duyệt
- Claude cho mạch lượng tử: bài test chuyên môn phải có người thẩm định
- Gemini 4 Argon trên WANDR: benchmark chỉ là cửa lọc ban đầu
- Ollama tại Seoul: quyết định mua còn phụ thuộc hệ sinh thái hỗ trợ
- Chi phí vận hành mô hình AI nằm ở công cụ, kiểm tra và năng lực chuyên môn
- Tác vụ tiếng Việt quyết định giá trị mô hình AI trong quy trình thật
- Ngân sách mô hình AI cần gắn với bài test đầu ra
- Nguồn tham khảo
Các mô hình AI mới không chỉ trả lời nhanh hơn. Chúng bắt đầu dùng tool, chia việc cho nhiều agent, tạo đầu ra bằng giọng nói và tham gia vào những bài toán chuyên môn như thiết kế mạch lượng tử. Với marketer Việt Nam, thay đổi quan trọng nhất là ngân sách không còn chỉ nằm ở phí dùng model mà còn nằm ở công cụ, kiểm tra và năng lực vận hành.
Luận điểm của bài này là: muốn đánh giá hiệu quả AI, doanh nghiệp phải tính chi phí theo phần việc hoàn tất và mức kiểm soát cần thiết, thay vì chỉ nhìn vào quyền truy cập một model.
Điểm chính
- AI đang chuyển từ một ô chat sang hệ thống có agent, tool, giọng nói và quy trình xử lý.
- Chi phí mới xuất hiện ở khâu điều phối, kiểm tra đầu ra, tích hợp dữ liệu và đào tạo người dùng.
- Benchmark giúp sàng lọc năng lực, nhưng không thay thế bài test trên quy trình marketing thật.
- Marketer Việt nên lập ngân sách theo tác vụ hoàn tất, thời gian kiểm duyệt và rủi ro sai sót.
Bối cảnh mô hình AI chuyển từ câu trả lời sang phần việc có công cụ
Các diễn biến trong nguồn cho thấy một hướng đi chung. OpenAI mô tả một dot có thể điều tra sự cố lúc 3 giờ sáng, mở một Codex thread và để kỹ sư điều khiển công việc từ điện thoại trong ứng dụng ChatGPT (OpenAI Developers). Một cập nhật khác cho phép nhiều agent xử lý các phần khác nhau của một nhiệm vụ song song, đồng thời cho người dùng theo dõi tiến độ và mở kết quả để kiểm tra (OpenAI).
Khả năng của model cũng được đưa ra ngoài màn hình chat. Claude được dùng để thiết kế mạch lượng tử từ hướng dẫn bằng ngôn ngữ tự nhiên, còn Gemini 4 Argon được giới thiệu cùng kết quả trên benchmark WANDR và có mặt trong Perplexity cho một số gói thuê bao (Anthropic; Perplexity). Ở phía ứng dụng, GPT-Live-1 cho phép nhà phát triển định hình giọng nói bằng prompt hoặc chọn voice quốc tế (OpenAI Developers), trong khi Ollama chuẩn bị làm việc với người dùng, khách hàng và đối tác tại Seoul cùng FriendliAI (Ollama).
Tính năng mô hình AI chạm tới phân bổ ngân sách marketing
Khối cập nhật dưới đây chỉ ghi nhận những khả năng được các đơn vị nêu rõ. Giá trị marketing của chúng không nằm ở tên model, mà ở việc đội ngũ phải thay đổi công việc nào để dùng được khả năng đó.
Nhiều agent song song: đội ngũ phải thiết kế điểm kiểm tra
Tính năng nhiều agent xử lý các phần khác nhau của một nhiệm vụ cho phép một yêu cầu được chia thành nhiều nhánh. Người dùng có thể theo dõi tiến độ và xem từng kết quả đã hoàn tất. Với marketing, công việc phù hợp là chia brief thành các phần như nghiên cứu, tạo phương án và kiểm tra, sau đó đặt người chịu trách nhiệm duyệt đầu ra. Nguồn OpenAI.
Dot xử lý sự cố: hoạt động trực ca cần tài liệu hóa quy trình
Một dot có thể điều tra sự cố, bắt đầu một Codex thread và cho kỹ sư điều khiển công việc từ điện thoại trong ChatGPT. Cách dùng này chạm tới các đội marketing có hoạt động liên tục như quảng cáo, CRM hoặc website: quy trình cần có log, quyền truy cập và điều kiện dừng trước khi giao việc cho AI. Nguồn OpenAI Developers.
Giọng nói cho GPT-Live-1: trải nghiệm audio cần thêm chi phí kiểm duyệt
GPT-Live-1 hỗ trợ tạo giọng nói bằng prompt hoặc chọn các voice quốc tế có sẵn. Điều này mở rộng phạm vi ứng dụng sang trợ lý thoại, nội dung audio và chăm sóc khách hàng. Đội marketing phải tính thêm bước duyệt phát âm, ngữ điệu, ngôn ngữ và cách giọng nói thể hiện thương hiệu. Nguồn OpenAI Developers.
Claude cho mạch lượng tử: bài test chuyên môn phải có người thẩm định
Claude Mythos 5 được mô tả là có thể thiết kế mạch lượng tử từ hướng dẫn thông thường và tạo ra các mạch hiệu quả hơn những kết quả đã công bố trong một số trường hợp. Với doanh nghiệp, ví dụ này nhắc rằng AI có thể tham gia việc khó, nhưng đầu ra vẫn cần chuyên gia kiểm tra trước khi được dùng làm căn cứ. Nguồn Anthropic.
Gemini 4 Argon trên WANDR: benchmark chỉ là cửa lọc ban đầu
Perplexity cho biết Gemini 4 Argon đạt kỷ lục mới trên WANDR và có sẵn cho người dùng Pro và Max. Marketer có thể dùng benchmark để rút ngắn danh sách model cần thử, nhưng vẫn phải đo trên brief, dữ liệu và tiêu chuẩn thương hiệu của mình. Nguồn Perplexity.
Ollama tại Seoul: quyết định mua còn phụ thuộc hệ sinh thái hỗ trợ
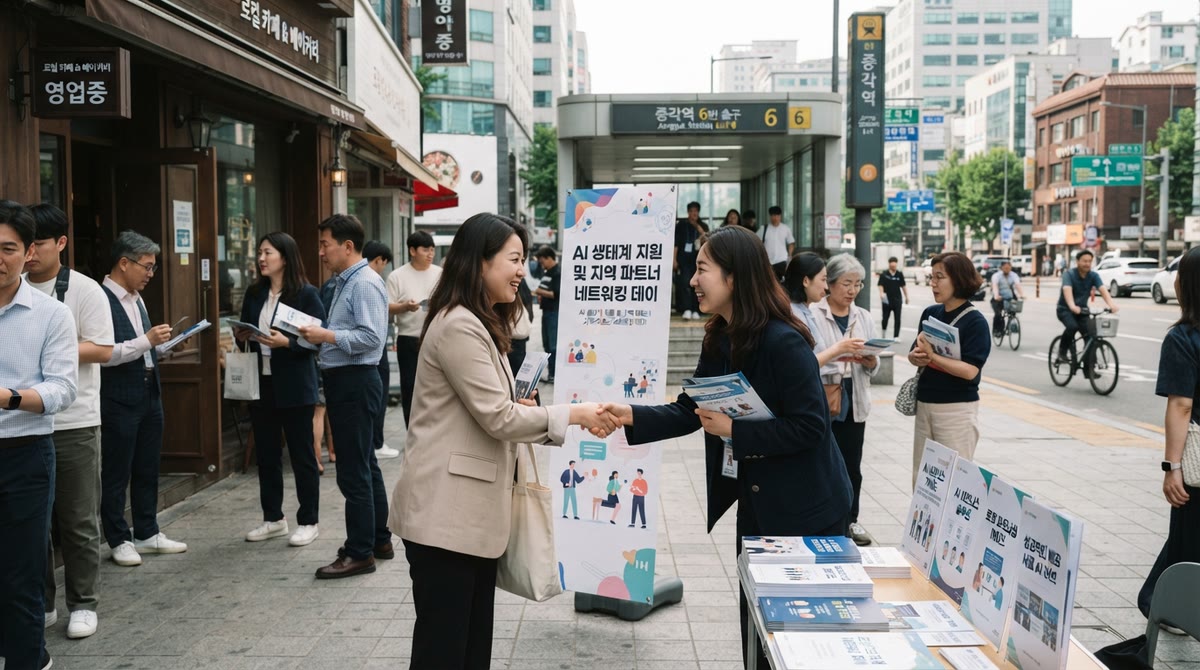
Ollama cho biết họ sẽ gặp người dùng, khách hàng, đối tác và làm việc cùng FriendliAI tại Seoul. Đây là dấu hiệu cho thấy việc chọn công cụ local hoặc self-hosted không chỉ là chọn model; doanh nghiệp còn phải tính cộng đồng, đối tác tích hợp và khả năng hỗ trợ triển khai. Nguồn Ollama.
Chi phí vận hành mô hình AI nằm ở công cụ, kiểm tra và năng lực chuyên môn
Phí dùng model chỉ là một phần khi agent bắt đầu làm việc
Một model trả lời trong chat chủ yếu tạo ra chi phí cho lượt gọi và thời gian người dùng. Khi nhiều agent chạy song song hoặc một dot tiếp tục điều tra sự cố, chi phí cần nhìn rộng hơn: số lần gọi tool, thời gian chạy, quyền truy cập hệ thống, lưu log và công sức con người để xem kết quả. Mô tả về nhiều agent của OpenAI và ví dụ dot xử lý sự cố cho thấy phần việc của AI đã kéo dài qua nhiều bước, không còn gói trong một câu trả lời (OpenAI; OpenAI Developers).
Vì vậy, câu hỏi ngân sách nên là “một phần việc hoàn tất tốn bao nhiêu tiền và bao nhiêu giờ kiểm tra”, thay vì chỉ hỏi model nào có giá thấp hơn.
Đầu ra chuyên môn và giọng nói kéo ngân sách sang khâu kiểm định
Thiết kế mạch lượng tử và tạo voice đều cho thấy cùng một cơ chế: khả năng tạo đầu ra mở rộng, nhưng tiêu chuẩn duyệt cũng cao hơn. Một voice cần được kiểm tra theo nhận diện thương hiệu và ngôn ngữ. Một thiết kế kỹ thuật cần chuyên gia xác nhận. Tương tự, nội dung marketing do AI tạo vẫn cần người duyệt theo brand safety, tính đúng đắn và mục tiêu chuyển đổi (Anthropic; OpenAI Developers).
Khoản chi này thường không xuất hiện trên bảng giá model. Nếu bỏ qua, doanh nghiệp dễ tưởng rằng AI làm giảm chi phí, trong khi thời gian chọn lọc và sửa lỗi tăng lên.
Benchmark và cộng đồng làm giảm chi phí thử sai, không xóa bài test
WANDR có thể giúp đội ngũ có một điểm tham chiếu khi so sánh model. Cộng đồng và đối tác địa phương như cách Ollama xây dựng tại Seoul có thể giúp giải quyết vấn đề triển khai. Tuy nhiên, cả benchmark lẫn mạng lưới hỗ trợ đều không trả lời thay cho bài test trên dữ liệu thật, quy trình thật và giới hạn quyền truy cập của doanh nghiệp (Perplexity; Ollama).
Tác vụ tiếng Việt quyết định giá trị mô hình AI trong quy trình thật
Ở Việt Nam, đội marketing không nên bắt đầu bằng việc chọn model có tên nổi bật. Hãy bắt đầu từ tác vụ có thể đo: viết biến thể quảng cáo theo quy định ngành, phân loại phản hồi khách hàng, tạo bản tóm tắt cuộc gọi, kiểm tra voice tiếng Việt hoặc hỗ trợ xử lý sự cố website.
Với mỗi tác vụ, cần ghi rõ dữ liệu được phép đưa vào, tool mà AI được dùng, ai duyệt, thời gian xử lý và tiêu chuẩn “xong”. Điều này đặc biệt cần thiết khi dùng agent hoặc công cụ local. Ollama cho thấy yếu tố cộng đồng và đối tác có thể ảnh hưởng đến khả năng triển khai; còn các ví dụ về voice, benchmark và thiết kế chuyên môn cho thấy chất lượng phải được đánh giá theo ngữ cảnh sử dụng.
Ngân sách thử nghiệm nên tách thành bốn phần: phí model, phí tool và hạ tầng, thời gian kiểm duyệt, cùng chi phí sửa lỗi. Cách tính này giúp doanh nghiệp so sánh một model rẻ nhưng cần nhiều người sửa với một model đắt hơn nhưng hoàn tất tác vụ ổn định hơn.
Ngân sách mô hình AI cần gắn với bài test đầu ra
- Chọn 3–5 tác vụ marketing có dữ liệu thật và định nghĩa rõ thế nào là hoàn tất trước khi mua thêm gói AI.
- Ghi riêng phí model, tool, hạ tầng, thời gian kiểm duyệt và chi phí sửa lỗi trong cùng một dashboard.
- Đặt điểm dừng cho agent: dữ liệu nào được đọc, hành động nào cần người duyệt và trường hợp nào phải chuyển cho chuyên gia.
- Đo lại sau mỗi chu kỳ thử nghiệm bằng tỷ lệ đầu ra dùng được, thời gian hoàn tất và số lần sửa, không chỉ bằng điểm benchmark.
Xem thêm phân tích & hướng dẫn marketing tại https://marketing365.vn.
Theo dõi thêm các bài phân tích từ Marketing365 để cập nhật xu hướng marketing mới nhất.
Đọc thêm các bài cùng chuyên mục Động thái AI.
Nguồn tham khảo
- Ollama — Bags packed. Ollama is headed to Seoul
- OpenAI Developers — Put your dot on call
- OpenAI — GPT-6 Astra Pro in ChatGPT got an upgrade
- Anthropic — Designing more efficient quantum circuits with Claude
- OpenAI Developers — Building apps with GPT-Live-1
- Perplexity — Gemini 4 Argon sets a new record on WANDR