Nội dung
- GB300 và CUDA-X đặt lại bối cảnh phân phối năng lực AI
- Năng lực GB300 và CUDA-X — chạm tới việc đội marketing phải làm khác đi
- Đường đi của GB300 tới người dùng làm đổi chi phí tiếp cận
- Doanh thu từ các cụm GB300 chưa đủ căn cứ để lập kế hoạch
- Kênh AI tại Việt Nam sẽ chịu tác động qua chi phí và tốc độ
- Đặt ngân sách GB300 và CUDA-X vào kiểm thử trước khi mở rộng
- Nguồn tham khảo
Hạ tầng AI không còn chỉ là chuyện của đội kỹ thuật. Khi các cụm máy dùng GB300 được xây nhanh hơn và CUDA-X giúp năng lực tính toán đi vào mô phỏng, sản xuất nội dung và nghiên cứu, marketer phải nhìn lại cách nội dung đến được người dùng và chi phí để duy trì kênh đó.
Luận điểm của bài này là: năng lực tính toán đang trở thành một phần của kênh phân phối AI. Doanh nghiệp không chỉ mua phần mềm; họ còn phụ thuộc vào nơi model được chạy, tốc độ mở rộng và mức chi cho mỗi lượt xử lý.
Điểm chính
- Cụm GB300 quy mô lớn cho thấy năng lực tính toán có thể được tổ chức như một hạ tầng phục vụ nhiều sản phẩm AI.
- CUDA-X mở rộng vai trò của GPU từ chạy model sang mô phỏng và kiểm thử ý tưởng, tức tạo thêm điểm tiếp xúc cho nội dung chuyên môn.
- Dự báo doanh thu gắn với tiến độ data center mới chỉ là ước tính cá nhân, chưa phải số liệu tài chính đã kiểm toán.
- Marketer Việt nên đo chi phí theo lượt xử lý, thời gian phản hồi và khả năng tiếp cận tệp khách, thay vì chỉ nhìn giá thuê công cụ.
GB300 và CUDA-X đặt lại bối cảnh phân phối năng lực AI
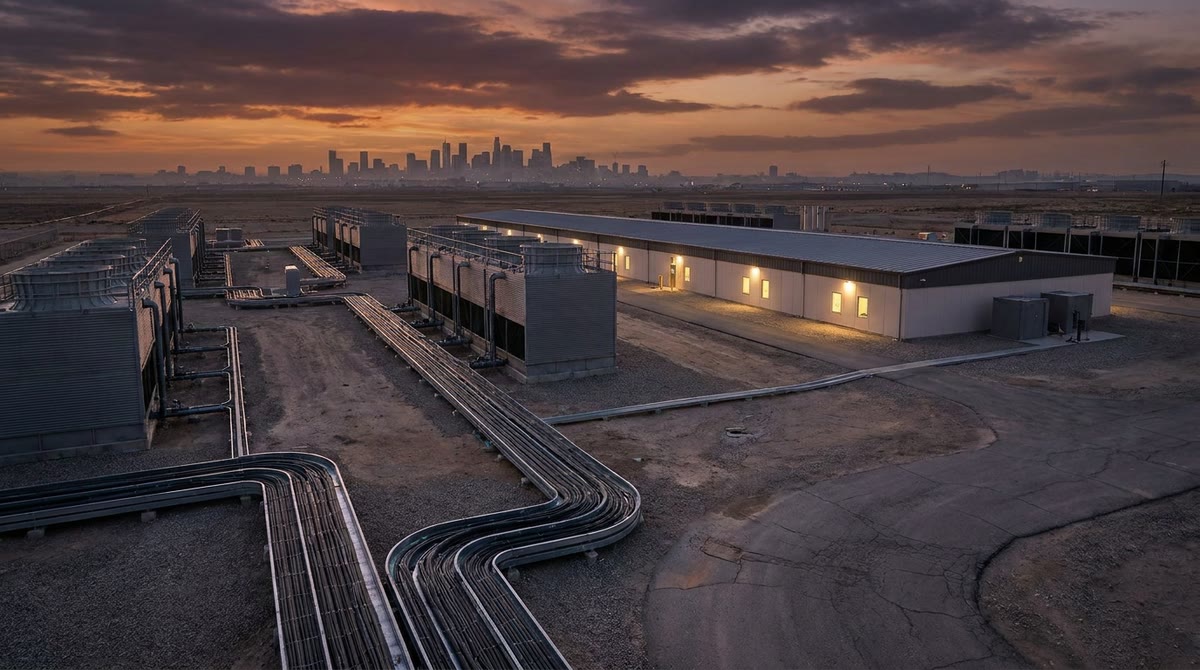
Một bài đăng của NextBigFuture dẫn lại trả lời của Elon Musk mô tả các cụm Macrohard và Minihard có khoảng 220.000 GPU GB300 cùng kết nối 800 gigabit cho training. Gun Range được nói là dùng cấu hình tương tự, còn Spam có khoảng 200.000 GB300 cho inference với nhu cầu mạng và cáp quang thấp hơn.
Ở hướng khác, NVIDIA giới thiệu CUDA-X như bộ phần mềm giúp các nhà khoa học và kỹ sư dùng GPU cho đồ họa, mô phỏng và kiểm thử. Hai diễn biến cùng chỉ về một thay đổi: AI được phân phối qua cả phần cứng lẫn phần mềm. Ai kiểm soát năng lực chạy và công cụ khai thác năng lực đó sẽ có nhiều lựa chọn hơn về tốc độ, quy mô và loại trải nghiệm cung cấp cho người dùng.
Năng lực GB300 và CUDA-X — chạm tới việc đội marketing phải làm khác đi
Khối này chỉ ghi nhận những thứ có thể kiểm tra trực tiếp trong hai nguồn, không biến các dự báo doanh thu thành kết quả đã xảy ra.
Cụm GB300 cho training và inference: đội marketing phải tách hai loại nhu cầu
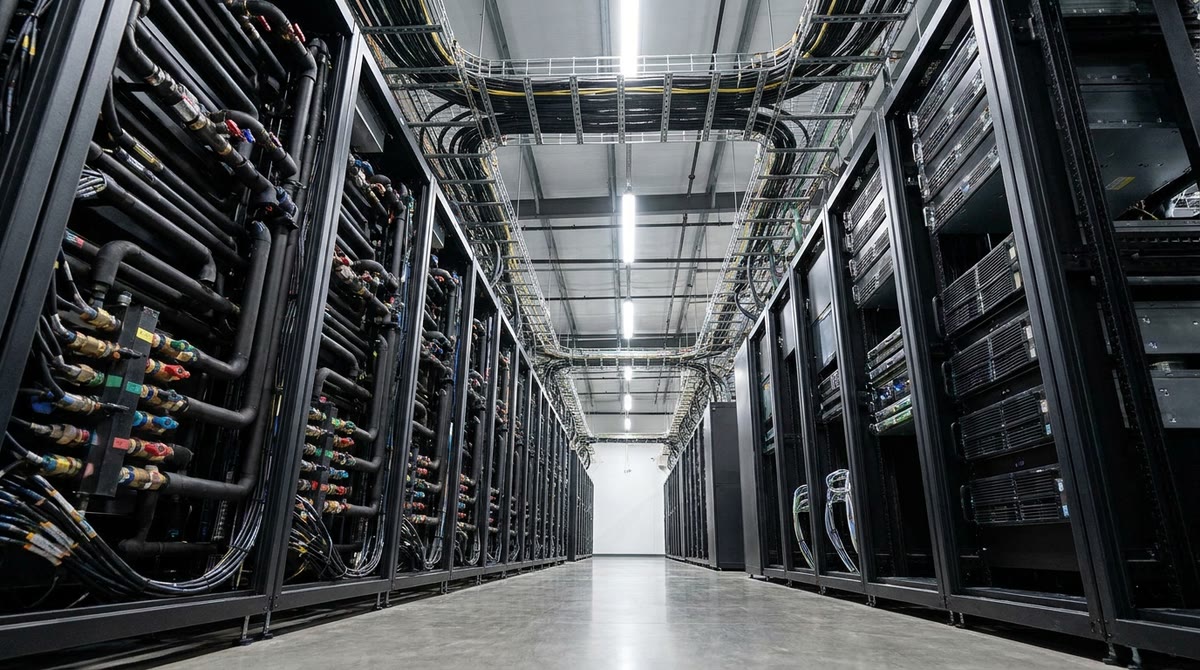
GB300 là dòng GPU được nguồn thứ nhất đặt trong các cụm data center cho hai việc khác nhau: training cần kết nối mạng dày hơn, còn inference có thể dùng cấu hình đơn giản hơn. Với marketer, khác biệt này liên quan đến cách chọn dịch vụ AI: tạo model, tinh chỉnh model và chạy nội dung cho khách hàng không phải cùng một loại chi phí. Nguồn về cấu hình GB300 là căn cứ cho các con số nêu trên.
CUDA-X: đội nội dung phải tính thêm giá trị của mô phỏng
CUDA-X là bộ phần mềm của NVIDIA cho các tác vụ như đồ họa, mô phỏng và kiểm thử ý tưởng khoa học, không chỉ là công cụ tạo văn bản hay hình ảnh. Điều đó mở thêm kênh để thương hiệu B2B biến dữ liệu kỹ thuật thành demo, mô hình trực quan hoặc nội dung giải thích. Bài giới thiệu CUDA-X của NVIDIA mô tả đúng nhóm ứng dụng này; còn nhu cầu phần cứng cho các workload AI quy mô lớn được minh họa qua mô tả các cụm GB300.
Đường đi của GB300 tới người dùng làm đổi chi phí tiếp cận
Chi phí mạng tách khỏi chi phí GPU trong mỗi kênh AI
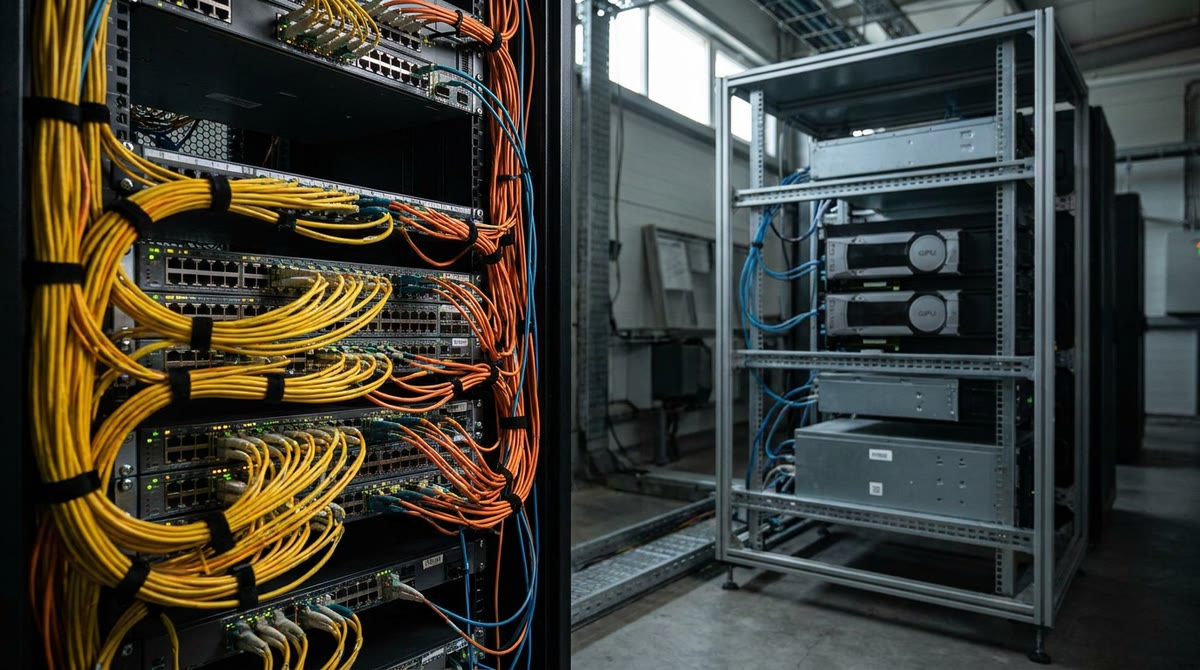
Hai nguồn cho thấy GPU không tự tạo ra một kênh phân phối hoàn chỉnh. Cấu hình training 220.000 GB300 đi cùng mạng 800 gigabit, trong khi inference được mô tả là cần ít cáp quang hơn. Cùng một model, chi phí để phục vụ người dùng có thể khác theo nơi chạy, kiểu truy vấn và mức truyền dữ liệu. Marketer vì thế cần yêu cầu nhà cung cấp nêu cả thời gian phản hồi, giới hạn throughput và phí dữ liệu, thay vì chỉ hỏi giá API.
CUDA-X bổ sung một lớp sử dụng khác: mô phỏng và đồ họa có thể tạo ra tài sản nội dung mới, nhưng cũng cần GPU, phần mềm và người vận hành. Khi nối hai dẫn chứng, kênh phân phối AI nên được hiểu là chuỗi gồm năng lực tính toán, công cụ xử lý và điểm đưa đầu ra tới khách hàng.
Thời gian mở rộng quyết định khả năng bán trải nghiệm AI
Musk được trích dẫn với kế hoạch Gun Range vận hành vào cuối tháng 11 và Spam vào tháng 12, cùng các ước tính doanh thu quý 4 và cả năm 2026. Đây là lời giải thích gắn doanh thu với tiến độ data center, không phải bằng chứng rằng doanh thu đã đạt mức đó. Đặt cạnh CUDA-X, ta thấy một cơ chế marketing cụ thể: khi năng lực chạy tăng, doanh nghiệp có thể phục vụ nhiều lượt mô phỏng, demo và inference hơn; nhưng giá trị chỉ xuất hiện nếu có tệp khách, nội dung và quy trình bán phù hợp.
Doanh thu từ các cụm GB300 chưa đủ căn cứ để lập kế hoạch
Liệu tốc độ xây data center có tự tạo ra doanh thu AI không?
Nguồn thứ nhất gắn các mốc vận hành của Gun Range và Spam với dự báo doanh thu của Tesla, Grok, Starlink và các hoạt động liên quan. Cần dán nhãn rõ: đây là phát biểu của Elon Musk được một tài khoản trên X diễn giải, gồm cả dự báo tương lai; không có báo cáo tài chính độc lập trong tư liệu xác nhận các con số đó.
Điều dùng được: đội marketing có thể xem tiến độ hạ tầng là biến cần theo dõi, nhưng không đưa doanh thu dự báo vào KPI. Hãy chờ số liệu công bố chính thức, sau đó đối chiếu số lượt dùng, tỷ lệ chuyển đổi, biên lợi nhuận và chi phí phục vụ từng nhóm khách hàng.
Kênh AI tại Việt Nam sẽ chịu tác động qua chi phí và tốc độ
Doanh nghiệp Việt thường không tự xây cụm hàng trăm nghìn GPU. Tác động thực tế đến từ các nền tảng cloud, API, công cụ tạo nội dung và dịch vụ mô phỏng sử dụng hạ tầng quốc tế. Khi phần cứng được mở rộng, giá và giới hạn sử dụng có thể thay đổi, nhưng không nên giả định giá sẽ tự giảm.
Marketer Việt cần hỏi nhà cung cấp ba việc: dữ liệu được xử lý ở đâu, phí tính theo lượt nào và đầu ra mất bao lâu. Với chiến dịch cần phản hồi nhanh, độ trễ có thể ảnh hưởng trực tiếp tới trải nghiệm khách hàng. Với nội dung B2B, CUDA-X gợi ý một hướng khác: đầu tư vào demo mô phỏng có thể giúp đội bán hàng giải thích sản phẩm, nhưng phải đo số cuộc hẹn và cơ hội bán hàng tạo ra.
Đặt ngân sách GB300 và CUDA-X vào kiểm thử trước khi mở rộng
- Chia ngân sách AI thành training, inference và mô phỏng; ghi riêng phí GPU, phí mạng, phí lưu trữ và nhân sự vận hành.
- Chọn một quy trình có đầu ra đo được, chẳng hạn tạo demo sản phẩm hoặc xử lý truy vấn khách hàng, rồi so sánh thời gian phản hồi với chi phí mỗi lượt.
- Yêu cầu nhà cung cấp công bố giới hạn throughput, dữ liệu lưu ở đâu và cách tính phí trước khi đưa AI vào kênh chăm sóc khách hàng.
- Không dùng dự báo doanh thu từ các bài đăng cá nhân làm căn cứ duyệt ngân sách; chỉ mở rộng khi số liệu chuyển đổi và tổng tiền thực tế phải bỏ ra đã được kiểm chứng.
Xem thêm phân tích & hướng dẫn marketing tại https://marketing365.vn.
Theo dõi thêm các bài phân tích từ Marketing365 để cập nhật xu hướng marketing mới nhất.
Đọc thêm các bài cùng chuyên mục Động thái AI.
Nguồn tham khảo
- NextBigFuture — Based upon key information provided by Elon Musk after faster data center and build completion
- NVIDIA — Sit back and enjoy the show: computer graphics and simulation powered by NVIDIA CUDA-X