Nội dung
- Suy luận AI chuyển từ chuyện tốc độ sang bài toán hạ tầng
- Hạ tầng suy luận đa chip chạm tới việc gì của marketing
- Năng lực CPU và GPU đổi cách chia việc trong đội marketing
- Chưa xác nhận: nhu cầu agentic và tỷ lệ CPU trong rack AI
- Bài toán CPU–GPU cho doanh nghiệp Việt
- Đo token, điện và thời gian phản hồi trước khi mở rộng agent
- Nguồn tham khảo
Hạ tầng AI không còn chỉ là chuyện chọn GPU mạnh nhất. Với agent phải lập kế hoạch, gọi công cụ và chạy liên tục, thời gian chờ, điện năng và cách chia việc giữa CPU với GPU bắt đầu ảnh hưởng trực tiếp đến trải nghiệm khách hàng và chi phí vận hành marketing.
Đây là vấn đề đáng chú ý với doanh nghiệp Việt vì một hệ thống agent chạy nhanh trên demo chưa chắc có tổng tiền hợp lý khi đưa vào quy trình thật. Marketer cần tham gia từ khâu đặt chỉ số, chọn tác vụ thử nghiệm đến nghiệm thu đầu ra.
Điểm chính
- Inference có nhiều phần việc khác nhau, nên một loại chip duy nhất có thể không tối ưu cho cả tốc độ phản hồi và tổng số tác vụ.
- Gimlet Labs cho biết phần mềm của họ chia các bước xử lý cho chip phù hợp từ sáu nhà sản xuất, thay vì khóa vào một dòng GPU.
- Nhu cầu agentic được mô tả là kéo theo nhu cầu CPU, GPU, điện và băng thông; đây là giả định cần kiểm chứng trước khi dùng để lập ngân sách.
- Đội marketing Việt nên đo thời gian phản hồi, token, điện năng và tỷ lệ lỗi trên một quy trình cụ thể trước khi mở rộng.
Suy luận AI chuyển từ chuyện tốc độ sang bài toán hạ tầng
Hai nguồn cùng chỉ về một thay đổi: workload của AI agent không giống một phiên chat đơn giản. Tư liệu về Gimlet Labs mô tả một tác vụ agent mất 10 phút ở tốc độ 100 token/giây có thể còn khoảng 20 giây ở 3.000 token/giây; công ty muốn biến mức phản hồi đó thành năng lực vận hành qua phần mềm điều phối nhiều loại chip. Trong một bài đăng khác, Mike LongTerm dẫn lời Elon Musk rằng nhu cầu agentic tăng nhanh, đồng thời liên hệ nhu cầu này với tỷ lệ CPU/GPU cân bằng hơn trong hệ thống AI (tư liệu về Gimlet Labs; bài đăng dẫn lời Musk).
Điểm chung không nằm ở việc một hãng chip nào thắng. Nó nằm ở cách tính năng lực phục vụ: một agent liên tục gọi API, chạy sandbox và xử lý nhiều bước cần cả tốc độ từng lượt lẫn khả năng xử lý nhiều lượt với cùng mức điện năng. Vì vậy, quyết định hạ tầng bắt đầu chạm tới cách marketing thiết kế workflow và đặt tiêu chuẩn trải nghiệm.
Hạ tầng suy luận đa chip chạm tới việc gì của marketing
Phần được kiểm chứng trong tư liệu là Gimlet Cloud cung cấp inference dạng serverless cho agent, còn phần mềm Gimlet làm việc với chip của NVIDIA, AMD, Intel, Arm, Cerebras và d-Matrix. Công ty tuyên bố có thể tăng mức tương tác hoặc số lượng tác vụ trên mỗi kilowatt từ 3 đến 10 lần, tùy mục tiêu giữ cố định. Đây là tuyên bố của doanh nghiệp, không nên xem như kết quả độc lập đã được xác nhận (nguồn Gimlet Labs).
Gimlet Cloud: đội marketing phải chốt SLA cho agent thay vì chỉ chọn model
Inference serverless cho phép đội sản phẩm thử một API chung thay vì tự quản từng loại chip. Với marketing, điều cần chốt trước là SLA: thời gian phản hồi tối đa, số lượt chạy mỗi ngày, tỷ lệ lỗi khi agent gọi công cụ và cách ghi nhận chi phí. Bài đăng về nhu cầu agentic cũng nhấn mạnh agent hoạt động liên tục và kéo theo nhu cầu compute, điện, băng thông; vì vậy, một bài test chỉ đo chất lượng câu trả lời là chưa đủ (nguồn Gimlet Labs; bài đăng về agentic demand).
Sáu loại chip: quy trình kiểm thử phải tách theo tác vụ
Gimlet mô tả inference gồm xử lý prompt, tạo câu trả lời, attention và feed-forward; mỗi phần gây áp lực khác nhau lên chip. Bài đăng thứ hai lại đặt vấn đề tỷ lệ CPU/GPU và khả năng dùng rack thiên về CPU cho agent. Hai góc nhìn này cùng cho thấy benchmark chung của model không thể thay thế bài test theo workflow. Marketer nên tách tác vụ như phân loại lead, gọi dữ liệu CRM, tạo nội dung và kiểm tra điều kiện trước khi nghiệm thu (nguồn Gimlet Labs; bài đăng về CPU/GPU).
Năng lực CPU và GPU đổi cách chia việc trong đội marketing
Thời gian chờ biến thành chỉ số trải nghiệm của khách hàng
Con số minh họa 10 phút xuống khoảng 20 giây cho thấy token/giây không chỉ là chỉ số kỹ thuật. Nó quyết định agent có thể hỗ trợ nhân viên bán hàng trong một phiên làm việc hay phải chạy nền rồi trả kết quả sau. Tư liệu Gimlet đặt trọng tâm vào interactivity; bài đăng về agentic demand lại mô tả các agent hoạt động liên tục. Vì thế, dashboard marketing nên có p95 thời gian phản hồi, thời gian hoàn tất workflow và số lần agent phải thử lại, bên cạnh CTR hay tỷ lệ chuyển đổi (nguồn Gimlet Labs; bài đăng về agentic demand).
Điện năng và tỷ lệ CPU/GPU kéo thêm vai trò vận hành vào marketing
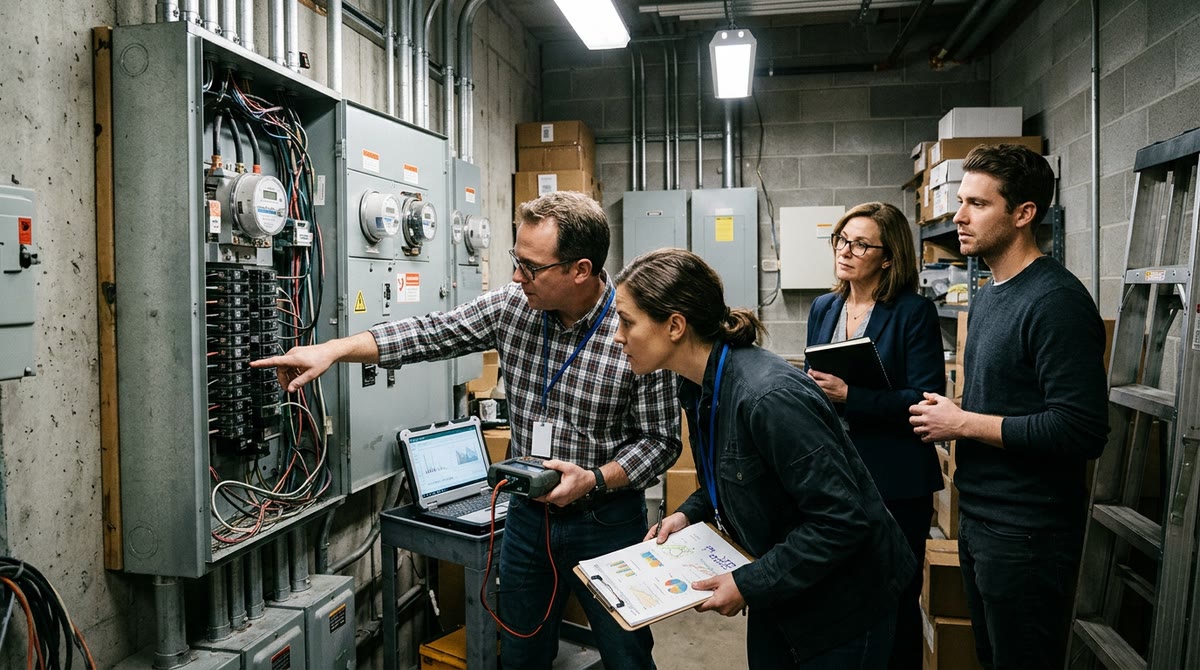
Gimlet dùng số tác vụ trên mỗi kilowatt như một mục tiêu tối ưu. Bài đăng còn lập luận rằng agent có thể làm tăng nhu cầu CPU, không chỉ GPU. Điều đó làm thay đổi nhóm người phải tham gia quyết định: marketer đặt yêu cầu đầu ra, kỹ sư đo tải, tài chính tính tiền điện và tổng chi phí chạy, còn pháp chế hoặc an toàn thông tin đặt giới hạn cho dữ liệu. Nếu chỉ giao việc cho nhóm mua model, doanh nghiệp dễ chọn theo tốc độ quảng cáo thay vì tổng tiền cho một workflow hoàn tất (nguồn Gimlet Labs; bài đăng về CPU/GPU).
Chưa xác nhận: nhu cầu agentic và tỷ lệ CPU trong rack AI
Agent có thật sự tăng nhanh hơn mọi công nghệ: cách tự kiểm thay vì tin cảm giác?
Một bài đăng trên X dẫn lời Elon Musk rằng “agentic demand” tăng nhanh hơn bất kỳ điều gì ông từng thấy, rồi suy luận rằng hệ thống agent sẽ cần nhiều CPU hơn. Trong phần tư liệu được cung cấp không có bản ghi trực tiếp hoặc xác nhận độc lập cho phát biểu này; đây là lời dẫn lại trên mạng xã hội và phần mở rộng là dự đoán cá nhân, không phải số liệu thị trường đã kiểm chứng.
Điều dùng được: đội marketing không cần dùng câu nói đó để dự báo ngân sách. Hãy lấy log của một workflow thật, đo số lượt gọi model, thời gian chạy, token, tỷ lệ lỗi và điện năng nếu có dữ liệu, rồi lập ba mức tải: thử nghiệm, vận hành thường xuyên và cao điểm.
Bài toán CPU–GPU cho doanh nghiệp Việt
Doanh nghiệp Việt thường bắt đầu với quy mô nhỏ, nên lợi ích của hạ tầng đa chip chỉ có ý nghĩa khi workload đủ lặp lại để đo. Một đội chạy vài trăm phiên agent mỗi tháng chưa chắc cần tự xây hệ thống phức tạp. Ngược lại, call center, thương mại điện tử và CRM có nhiều tác vụ liên tục có thể cần tính cả CPU cho orchestration, API và sandbox, không chỉ GPU cho tạo câu trả lời.
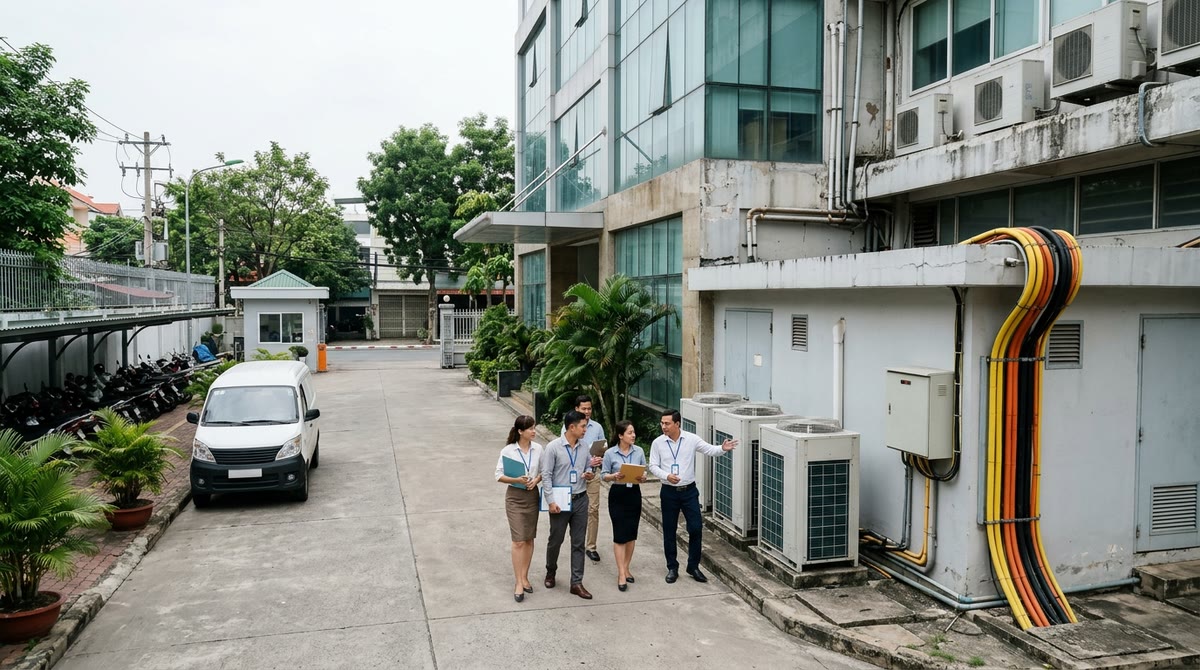
Marketer nên yêu cầu nhà cung cấp trả lời bằng số của chính quy trình: thời gian phản hồi ở p95, chi phí cho một workflow hoàn tất, số token, tỷ lệ gọi lại và cách chuyển workload khi một loại chip quá tải. Các tuyên bố 3–10 lần của Gimlet chỉ là điểm cần kiểm chứng bằng dữ liệu riêng. Nhận định về rack CPU cũng nên được xem như giả thuyết thiết kế, chưa phải lý do đủ để mua phần cứng.
Đo token, điện và thời gian phản hồi trước khi mở rộng agent
- Chọn một workflow có đầu ra rõ, chẳng hạn chấm lead hoặc tổng hợp yêu cầu khách hàng, rồi ghi lại token, số lần gọi công cụ và thời gian hoàn tất.
- Đặt hai ngưỡng nghiệm thu: thời gian phản hồi người dùng nhìn thấy và chi phí cho một lần chạy thành công.
- Yêu cầu kỹ thuật so sánh CPU, GPU và cấu hình đa chip trên cùng dữ liệu, cùng prompt và cùng khối lượng công việc.
- Chỉ mở rộng ngân sách khi dashboard có dữ liệu về lỗi, thử lại, điện năng hoặc hóa đơn compute trong ít nhất một chu kỳ vận hành phù hợp.
Xem thêm phân tích & hướng dẫn marketing tại https://marketing365.vn.
Theo dõi thêm các bài phân tích từ Marketing365 để cập nhật xu hướng marketing mới nhất.
Đọc thêm các bài cùng chuyên mục Động thái AI.
Nguồn tham khảo
- An AI agent task that takes 10 minutes at 100 tokens per second would take about 20 seconds at 3,000. Gimlet… — Pukerainbow
- BREAKING $AMD | @elonmusk just said “Agentic demand is growing faster than I’ve ever seen anything grow” — Mike