Nội dung
- Model AI mới bước vào cuộc đua bằng giá, tốc độ và máy chạy
- Những thay đổi ở model AI mới — chạm tới cách chọn công cụ marketing
- Giá mỗi tác vụ và giới hạn hạ tầng đổi cách đo hiệu quả model AI
- Gemini 4 Argon chưa xác nhận điều gì về khả năng dùng thật?
- Model AI mới vào thị trường Việt Nam qua dữ liệu, license và máy chạy
- Marketer Việt cần chốt model theo tác vụ trước khi tăng ngân sách
- Nguồn tham khảo
Các model AI mới đang cạnh tranh không chỉ bằng điểm benchmark mà bằng giá mỗi tác vụ, tốc độ chạy, khả năng tích hợp và điều kiện hạ tầng. Với marketer Việt Nam, điều này làm thay đổi cách chọn công cụ: model có điểm cao nhất chưa chắc tạo ra hiệu quả tốt nhất nếu chi phí và quy trình kiểm duyệt không phù hợp.
Điểm chính
- Giá mỗi tác vụ có thể chênh lệch nhiều lần giữa các model cùng đứng ở nhóm đầu.
- Model open weights mở thêm lựa chọn, nhưng license, máy chạy và khả năng tích hợp vẫn là điều kiện bắt buộc.
- Tốc độ và vốn xây data center cho thấy hiệu quả AI phụ thuộc cả vào hạ tầng, không chỉ vào model.
- Marketer nên chọn model theo tác vụ, chi phí trên đầu ra và điểm kiểm duyệt trước khi mở rộng ngân sách.
Model AI mới bước vào cuộc đua bằng giá, tốc độ và máy chạy
Các dữ liệu được công bố cho thấy thị trường model AI mới đang tách thành nhiều lớp lựa chọn. Trên Coding Agent Index, Claude Sonnet 5.5 đạt 68 điểm với chi phí đo được 14,19 USD mỗi tác vụ; Gemini 4 Argon đạt 64 điểm và 5,84 USD; GPT-6.1 Sol đạt 63 điểm nhưng chỉ 1,04 USD mỗi tác vụ. Chỉ số này đo agent gồm model và harness qua ba bài đánh giá coding, nên không thể dùng trực tiếp để kết luận model nào tốt nhất cho mọi hoạt động marketing. Artificial Analysis cũng lưu ý mức giá của Argon là giá khuyến mại và model chưa mở công khai.
Ở phía hạ tầng, NVIDIA cho biết GPT-6 Astra Ultrafast chạy trên hệ thống của họ có thể nhanh hơn tới 8 lần, còn dữ liệu xây dựng data center tại Mỹ đã tiến gần nhịp 85 tỷ USD mỗi năm, tăng 73% so với cùng kỳ và 513% từ khi ChatGPT ra mắt. Những con số này đặt cùng một vấn đề cho người mua AI: hiệu quả không nằm riêng trong câu trả lời, mà còn ở tốc độ phản hồi, máy chạy và tổng tiền phải bỏ ra. NVIDIA và Joey Politano là hai nguồn cho phần bối cảnh này.
Những thay đổi ở model AI mới — chạm tới cách chọn công cụ marketing
Phần được kiểm chứng cho thấy marketer đã có thêm các lựa chọn cụ thể, nhưng mỗi lựa chọn đi kèm một điều kiện vận hành khác nhau.
GPT-6.1 Sol: bài toán chi phí trên mỗi tác vụ
GPT-6.1 Sol trong Codex đạt 63 điểm với mức chi phí đo được 1,04 USD mỗi tác vụ trên Coding Agent Index. Con số này không chứng minh model luôn cho đầu ra tốt hơn, nhưng tạo cơ sở để đội marketing thử các việc có tần suất cao như viết biến thể nội dung, kiểm tra cấu trúc landing page hoặc hỗ trợ lập trình dashboard. Việc chọn model cần gắn với chi phí trên một đầu ra đạt yêu cầu, thay vì chỉ nhìn điểm xếp hạng. Nguồn Artificial Analysis. Với Qwen-Image-2.1, logic này cũng xuất hiện ở mảng hình ảnh: model được chạy cục bộ, có native 2K và hỗ trợ nền trong suốt, nhưng license thương mại cần được kiểm tra riêng. Nguồn Qwen-Image-2.1.
Qwen-Image-2.1 và GLM 5.3: open weights không đồng nghĩa miễn phí
Qwen-Image-2.1 đứng đầu nhóm open weights trên hai bảng xếp hạng hình ảnh của Artificial Analysis, tăng từ hạng 72 lên 18 ở text-to-image và từ 58 lên 18 ở image editing. Model có component tạo hình 7B tham số, hỗ trợ text-to-image, chỉnh sửa ảnh và đã có hỗ trợ trong Diffusers, ComfyUI, vLLM-Omni, SGLang và LightX2V. Tuy nhiên, Qwen Research License yêu cầu license riêng cho mục đích thương mại. GLM 5.3 và GLM 5.3 Flash có mặt trong Cursor, còn GLM 5.3 Max được Cursor mô tả là open-weight model có điểm cao nhất trên CursorBench 4.0. Các dữ kiện này cho thấy đội ngũ cần kiểm tra cả license, môi trường chạy và công cụ tích hợp trước khi đưa model vào quy trình. Nguồn Artificial Analysis về Qwen và Cursor.
Giá mỗi tác vụ và giới hạn hạ tầng đổi cách đo hiệu quả model AI
Chi phí suy luận buộc marketer tách việc khó khỏi việc lặp lại
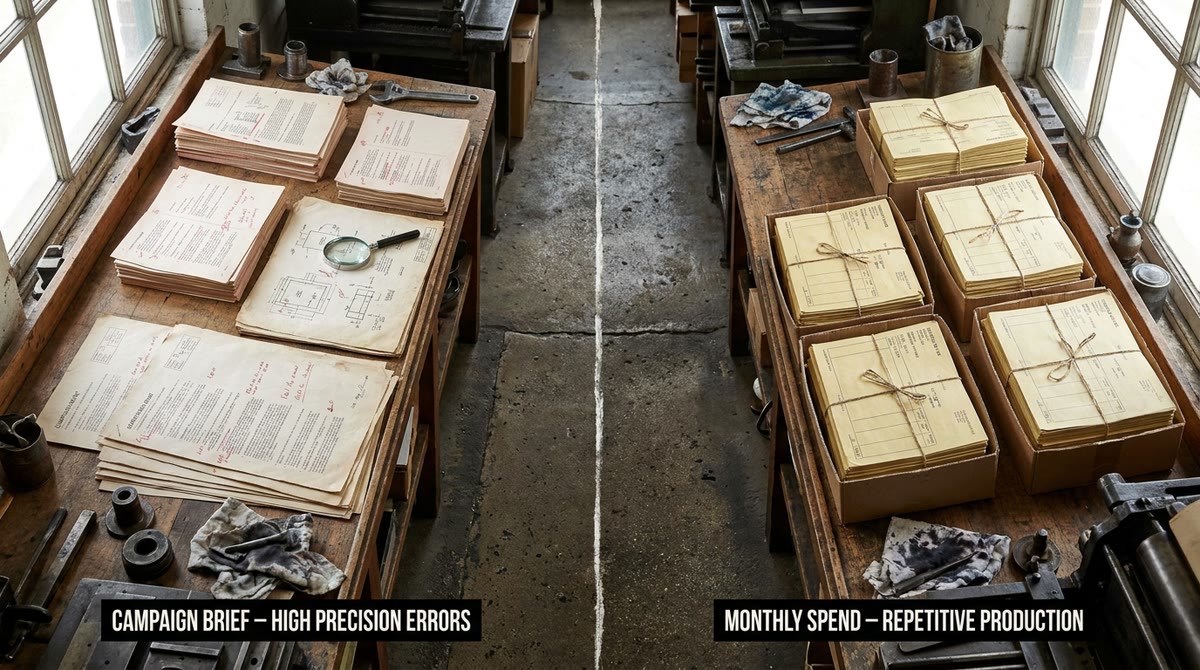
Chênh lệch giữa 14,19 USD, 5,84 USD và 1,04 USD cho mỗi tác vụ cho thấy một bảng xếp hạng duy nhất không đủ để quyết định mua model. Tác vụ cần độ chính xác cao có thể chấp nhận model đắt hơn nếu giảm thời gian sửa lỗi. Ngược lại, các việc lặp lại với khối lượng lớn cần được tính theo tổng tiền hàng tháng và tỷ lệ đầu ra phải làm lại. Kết quả Qwen-Image-2.1 cũng gợi ý một hướng khác: chạy cục bộ có thể giảm phụ thuộc vào nhà cung cấp, nhưng doanh nghiệp phải tự chịu tiền máy, bảo trì và kiểm soát license. Artificial Analysis về coding agent và Artificial Analysis về image model cung cấp hai ví dụ cùng một cơ chế chi phí.
Tốc độ và máy chạy quyết định model có đi vào quy trình hay không
Thông tin GPT-6 Astra Ultrafast có thể nhanh hơn tới 8 lần cho thấy tốc độ là một biến số của trải nghiệm khách hàng và năng suất đội ngũ. Nhưng tốc độ chỉ tạo giá trị khi hệ thống có đủ máy, dữ liệu và kết nối để phục vụ khối lượng thật. Việc chi tiêu xây data center tại Mỹ tiến gần 85 tỷ USD mỗi năm cho thấy năng lực phục vụ AI đang cần vốn rất lớn, không phải một tính năng có thể bật lên mà không phát sinh chi phí. Vì vậy, marketer phải đo thời gian chờ, số lượt gọi model và tỷ lệ lỗi cùng với chất lượng đầu ra. NVIDIA và Joey Politano là căn cứ cho hai mặt tốc độ và hạ tầng.
Điểm benchmark không thay thế được bước duyệt đầu ra
CursorBench 4.0 và Coding Agent Index đo những nhóm tác vụ cụ thể, trong khi đội marketing còn phải xử lý tiếng Việt, brand guideline, dữ liệu khách hàng và yêu cầu pháp lý nội bộ. Việc Qwen-Image-2.1 tăng thứ hạng mạnh trên hai bảng hình ảnh không tự động chứng minh nó phù hợp với bộ nhận diện của một thương hiệu Việt. Cách đo thiết thực hơn là lập bộ tác vụ đại diện, ghi tỷ lệ đầu ra đạt chuẩn, thời gian sửa và tiền cho mỗi đầu ra. Cursor và Artificial Analysis cùng cho thấy benchmark hữu ích nhất khi được đọc trong đúng bối cảnh tác vụ.
Gemini 4 Argon chưa xác nhận điều gì về khả năng dùng thật?
Giá khuyến mại có phản ánh ngân sách dài hạn không?
Đang lan truyền nội dung giới thiệu Gemini 4 Argon theo lối hài hước do một người dùng đăng sau khi yêu cầu Gemini tạo lời công bố. Đây là lời kể và nội dung sáng tạo của người dùng, không phải xác nhận chính thức từ Google. Artificial Analysis ghi Argon đạt 64 điểm với chi phí 5,84 USD mỗi tác vụ, đồng thời nói rõ model chưa mở công khai và mức giá dùng để đo là giá khuyến mại.
Điều dùng được: đội marketing chỉ nên dùng số liệu này để thiết kế kịch bản thử nghiệm giả định. Không đưa Argon vào kế hoạch mua hoặc cam kết hiệu quả cho tới khi có quyền truy cập, bảng giá và điều khoản thương mại có thể kiểm tra. Bài đăng của Dmitry Lyalin và đánh giá Artificial Analysis là hai nguồn cần đọc cùng nhau.
Model AI mới vào thị trường Việt Nam qua dữ liệu, license và máy chạy
Doanh nghiệp Việt không nên chọn model chỉ vì tên tuổi hoặc điểm cao trên bảng quốc tế. Qwen-Image-2.1 có hỗ trợ chạy cục bộ và nhiều công cụ triển khai, nhưng license thương mại riêng có thể ảnh hưởng trực tiếp tới việc dùng cho quảng cáo, thương mại điện tử hoặc sản phẩm khách hàng. GLM 5.3 trong Cursor cho thấy một model open-weight chỉ tạo giá trị khi nằm trong công cụ mà đội ngũ đã dùng và có thể kiểm soát.
Với ngân sách hạn chế, bài kiểm tra nên dùng dữ liệu tiếng Việt thật đã được làm sạch, brief thương hiệu thật và quy trình duyệt hiện có. Đội ngũ cũng cần tính tiền máy nếu chạy cục bộ, tiền gọi API nếu dùng dịch vụ bên ngoài, cùng thời gian sửa của nhân sự. Quy mô đầu tư data center tại Mỹ không phải chi phí mà doanh nghiệp Việt phải sao chép, nhưng là lời nhắc rằng tốc độ và khả năng phục vụ luôn cần một nền hạ tầng phía sau. Artificial Analysis, Cursor và Joey Politano cung cấp cơ sở cho các điểm này.
Marketer Việt cần chốt model theo tác vụ trước khi tăng ngân sách
- Lập bảng so sánh ít nhất ba model theo giá trên một đầu ra đạt chuẩn, thời gian phản hồi và số lần phải sửa.
- Chia tác vụ thành nhóm cần độ chính xác cao và nhóm lặp lại số lượng lớn, rồi chọn model theo tổng tiền thực tế của từng nhóm.
- Kiểm tra license thương mại, dữ liệu gửi ra ngoài và khả năng chạy trong công cụ đang dùng trước khi đưa open weights vào sản xuất.
- Chạy thử trên brief tiếng Việt và bộ nhận diện thật, giữ điểm duyệt của con người trước khi mở rộng quyền cho AI.
Cách tiếp cận này giúp marketer nhìn model AI mới như một khoản đầu tư gắn với công việc cụ thể. Điểm số vẫn hữu ích để sàng lọc, nhưng quyết định ngân sách phải dựa trên đầu ra đạt chuẩn, máy chạy và tổng tiền vận hành.
Xem thêm phân tích & hướng dẫn marketing tại https://marketing365.vn.
Theo dõi thêm các bài phân tích từ Marketing365 để cập nhật xu hướng marketing mới nhất.
Đọc thêm các bài cùng chuyên mục Động thái AI.
Nguồn tham khảo
- Artificial Analysis: Claude Sonnet 5.5, GPT-6.1 Sol và Gemini 4 Argon trên Coding Agent Index
- NVIDIA: GPT-6 Astra Ultrafast chạy trên NVIDIA
- Dmitry Lyalin: nội dung hài hước về Gemini 4 Argon
- Artificial Analysis: Qwen-Image-2.1 dẫn đầu nhóm open weights
- Cursor: GLM 5.3 và GLM 5.3 Flash trong Cursor
- Joey Politano: xây dựng data center tại Mỹ tiến gần nhịp 85 tỷ USD mỗi năm