Nội dung
- Sáu tín hiệu model AI đang đổi cách đánh giá năng lực
- Mức giá Gemini 4 Argon chạm tới quyền truy cập và chi phí thử nghiệm
- Độ tin cậy của model AI nằm ở dữ liệu và dấu vết kiểm tra
- Tin đồn về Fable 5.5 và quyền truy cập Argon cần được tự kiểm
- Khách hàng Việt trước model AI chọn theo nhiệm vụ
- Đo provenance trước khi cho agent chạm dữ liệu thật
- Nguồn tham khảo
Model AI mới đang được đánh giá không chỉ bằng khả năng tạo câu trả lời, mà bằng việc nó có chọn đúng công cụ, gọi đúng dữ liệu và để lại đủ bằng chứng hay không. Với marketer Việt Nam, thay đổi này ảnh hưởng trực tiếp đến ngân sách API, quy trình duyệt nội dung và trách nhiệm khi dữ liệu đầu vào chưa đầy đủ.
Điểm chính
- Giá trị của model chuyển từ một bảng xếp hạng năng lực sang khả năng chọn model phù hợp cho từng nhiệm vụ.
- Dữ liệu ngoài Internet có thể được đặt hàng từ con người, nhưng thời gian, nguồn gốc và độ tin cậy vẫn phải được kiểm tra.
- Quyền truy cập giới hạn và các tuyên bố chưa xác nhận khiến marketer phải tách rõ thông tin đã dùng được với kỳ vọng.
- Đội ngũ tại Việt Nam cần đặt điểm duyệt, lưu provenance và thử trên quy trình tiếng Việt trước khi tăng ngân sách.
Sáu tín hiệu model AI đang đổi cách đánh giá năng lực
Các nguồn được cung cấp cùng chỉ về một thay đổi: model AI ngày càng trở thành một phần trong quy trình ra quyết định, thay vì chỉ là công cụ trả lời. Bài đăng của DogeDesigner mô tả ý tưởng Grok Bot chọn API phù hợp nhất cho từng việc, từ Claude Opus 5.5 đến Midjourney và Suno, với mục tiêu tối ưu kết quả theo nhiệm vụ (nguồn 1).
Ở chiều ngược lại, Vangrid được mô tả như một cách để agent đặt bounty cho người đi thu thập dữ liệu vật lý. Khoản thanh toán có thể xử lý nhanh, nhưng việc di chuyển, quay phim, tải dữ liệu và đối chiếu nhiều lần vẫn cần thời gian của con người (nguồn 2). Cùng lúc, Gemini 4 Argon được nêu với cửa sổ output 1 triệu token và mức giá API cụ thể, còn một model chưa phát hành của OpenAI được cho là đã chứng minh một mệnh đề toán học bằng Lean (nguồn 5; nguồn 6). Những ví dụ này không chứng minh mọi tuyên bố đều đúng, nhưng cho thấy tiêu chuẩn mua và dùng AI đang rộng hơn điểm benchmark.
Mức giá Gemini 4 Argon chạm tới quyền truy cập và chi phí thử nghiệm
Khối cập nhật chỉ giữ thông tin có thể đối chiếu trong chính tài liệu nguồn. Phần này không gộp các lời kể về quyền truy cập cá nhân hay dự đoán lịch phát hành vào cùng một nhóm.
Gemini 4 Argon: đội marketing phải tách giá API khỏi quyền dùng thực tế
Nguồn tổng hợp về Gemini 4 Argon nêu cửa sổ output 1 triệu token, phạm vi ứng dụng gồm coding, knowledge work và cyber defense, cùng mức giá giới thiệu 2 USD/10 USD rồi 4 USD/20 USD theo loại token. Tuy nhiên, quyền dùng được mô tả là vẫn giới hạn cho nhóm thử nghiệm và một số chương trình cụ thể, chưa mở đầy đủ cho các gói người dùng trả phí (nguồn 5). Với marketing, bảng giá chỉ là đầu vào cho dự toán. Trước khi đưa model vào dashboard, cần xác nhận tài khoản nào được dùng, giới hạn nào áp dụng và đầu ra dài hơn có thực sự cần cho công việc hay không.
Độ tin cậy của model AI nằm ở dữ liệu và dấu vết kiểm tra
Chọn model theo nhiệm vụ: ngân sách API phải đi cùng trách nhiệm giải trình
Ý tưởng để hệ thống tự chọn API phù hợp nhất cho từng việc có thể giúp đội marketing không phải ép một model làm mọi nhiệm vụ. Nhưng nguồn về Grok Bot cũng cho thấy quyết định chọn model có thể chuyển vào phần mềm thay vì nằm trong tay người dùng (nguồn 1). Đặt cạnh mức giá và quyền truy cập còn giới hạn của Gemini 4 Argon (nguồn 5), cơ chế này tạo ra ba việc phải làm: ghi lại model đã được gọi, tách chi phí theo nhiệm vụ và đặt ngưỡng để người duyệt can thiệp. Nếu không có ba lớp kiểm tra đó, báo cáo hiệu quả chỉ cho thấy đầu ra cuối cùng mà không giải thích được vì sao chi phí thay đổi.
Dữ liệu vật lý: tốc độ thanh toán không thay thế được kiểm chứng hiện trường
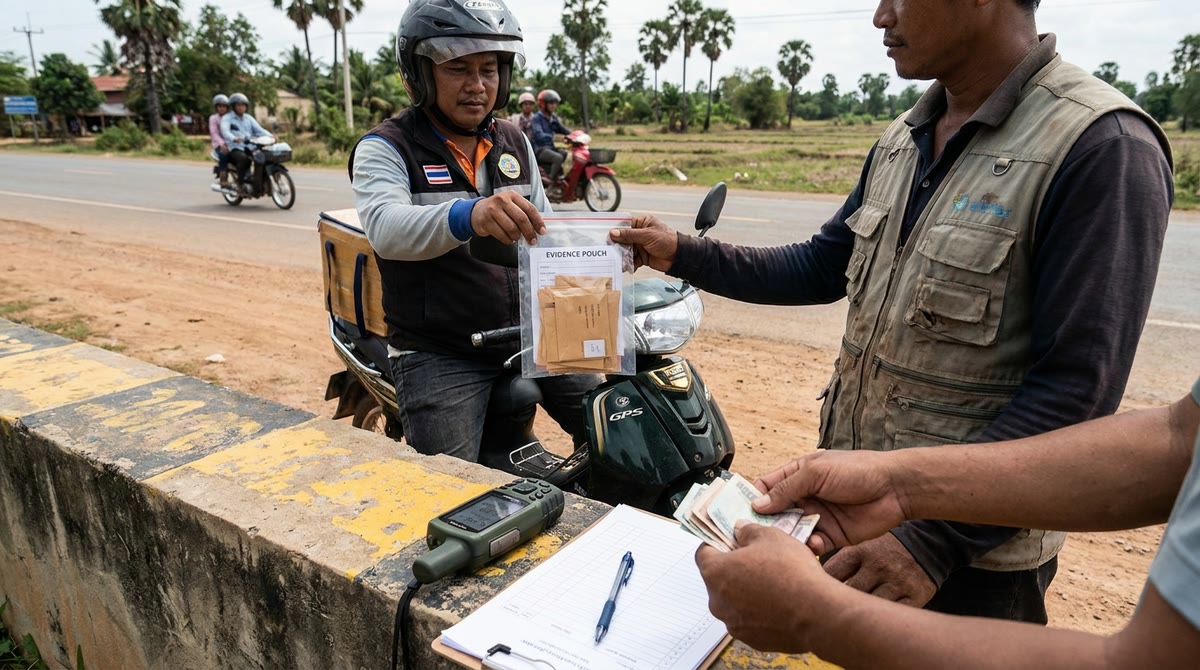
Mô tả về Vangrid cho thấy agent có thể đặt bounty 50–5.000 USD, kèm địa điểm, yêu cầu, số tiền và hạn chót để một người thu thập dữ liệu. Dữ liệu sau đó được gắn hash, vị trí gần đúng, thời điểm và dấu vết Merkle trên Base; nguồn cũng nhấn mạnh một lần quay không tự động trở thành ground truth (nguồn 2). Điều này liên quan trực tiếp đến tuyên bố về model có thể xử lý bài toán toán học bằng Lean (nguồn 6): một đầu ra có hình thức kiểm tra tốt vẫn cần người đọc hiểu điều kiện và phạm vi đúng. Marketer nên xem provenance, số lần đối chiếu và tiêu chí chấp nhận là một phần của sản phẩm dữ liệu, không phải thủ tục sau cùng.
Đầu ra có thể kiểm tra: năng lực model chưa đủ để phê duyệt nội dung
Gemini 4 Argon được mô tả là phục vụ coding, knowledge work và cyber defense, trong khi model chưa phát hành của OpenAI được gắn với formalization bằng Lean (nguồn 5; nguồn 6). Hai ví dụ này gợi ra một nguyên tắc cho marketing: năng lực chuyên môn không đồng nghĩa với đầu ra phù hợp thương hiệu. Quy trình cần lưu prompt, dữ liệu đã đưa vào, model được chọn, phiên bản đầu ra và người duyệt. Với nội dung có bản quyền, dữ liệu khách hàng hoặc thông tin nhạy cảm, cần thêm bước kiểm tra quyền sử dụng trước khi xuất bản.
Tin đồn về Fable 5.5 và quyền truy cập Argon cần được tự kiểm
Fable 5.5 hay Haiku 5.5: marketer đang nghe dự đoán hay thông báo chính thức?
Một bài đăng cho rằng tin đồn Fable 5.5 ra mắt vào ngày 6 tháng 10 là sai, rồi suy đoán Haiku 5.5 có thể xuất hiện trước còn Fable bị giữ lại lâu hơn. Đây là phỏng đoán cá nhân của Token Gremlin, không phải xác nhận từ Anthropic (nguồn 3).
Điều dùng được: không đưa tên model chưa xác nhận vào kế hoạch nội dung, báo giá hay cam kết năng lực. Hãy ghi rõ trạng thái “chưa xác nhận”, sau đó kiểm tra trang tài liệu, bảng giá và API chính thức trước khi thử nghiệm.
Quyền truy cập Argon có thật sự mở rộng không?
Một bài đăng khác nói rằng Gemini 4 Argon đã xuất hiện với một số người dùng và có thể được mở rộng trong vài ngày. Đây là lời kể từ các tài khoản cá nhân; nội dung nguồn không cho thấy Google đã xác nhận một đợt mở rộng đại trà (nguồn 4).
Điều dùng được: đội marketing chỉ nên coi quyền truy cập là có thật sau khi tài khoản của mình gọi được model, có giới hạn và hóa đơn rõ ràng. Không lấy ảnh chụp giao diện hoặc lời kể người dùng làm căn cứ phân bổ ngân sách.
Model OpenAI chứng minh định lý: kết quả có thể dùng ngay không?
Bài đăng của Dr Singularity mô tả một model OpenAI chưa phát hành đã chứng minh giả thuyết quasi-Riemann và phát hành formalization bằng Lean. Đây là tuyên bố về một model chưa công bố, chưa có xác nhận độc lập trong dữ liệu nguồn (nguồn 6).
Điều dùng được: xem đây là tín hiệu để đặt câu hỏi về cách kiểm chứng, không phải lý do đổi model ngay. Chỉ thử trong môi trường riêng khi có tài liệu, quyền truy cập và tiêu chí đánh giá có thể lặp lại.
Khách hàng Việt trước model AI chọn theo nhiệm vụ
Doanh nghiệp Việt thường phải xử lý dữ liệu tiếng Việt không đồng đều, từ brief, bình luận, lịch sử chăm sóc đến tài liệu sản phẩm. Trong bối cảnh một agent có thể tự chọn nhiều API, rủi ro không chỉ là câu trả lời sai. Dữ liệu có thể bị gửi sang nơi đội marketing chưa rà soát, hoặc chi phí tăng vì hệ thống gọi model đắt hơn cho một nhiệm vụ vốn có thể xử lý bằng model nhẹ hơn.
Vì vậy, thử nghiệm nên bắt đầu từ một quy trình hẹp như phân loại phản hồi khách hàng hoặc tạo biến thể quảng cáo. Đội ngũ cần giữ một bộ dữ liệu tiếng Việt đã được ẩn thông tin cá nhân, đặt tiêu chí chấp nhận bằng CTR, tỷ lệ được duyệt hoặc thời gian xử lý, rồi so sánh cả chất lượng lẫn tổng tiền thực tế phải bỏ ra. Với dữ liệu hiện trường, cần ghi rõ ai thu thập, ở đâu, lúc nào và có bao nhiêu lần đối chiếu.
Đo provenance trước khi cho agent chạm dữ liệu thật
- Lập danh sách nhiệm vụ và quy định model nào được phép xử lý từng loại dữ liệu trước khi bật cơ chế tự chọn API.
- Ghi log model, phiên bản, prompt, dữ liệu đầu vào, chi phí và người duyệt cho mọi đầu ra được dùng trong chiến dịch.
- Kiểm tra quyền sử dụng, thông tin cá nhân và nguồn gốc dữ liệu trước khi đưa kết quả vào quảng cáo hoặc CRM.
- Chỉ tăng ngân sách sau khi một quy trình tiếng Việt đạt tiêu chí chất lượng, chi phí và khả năng giải trình trong nhiều vòng kiểm thử.
Xem thêm phân tích & hướng dẫn marketing tại https://marketing365.vn.
Theo dõi thêm các bài phân tích từ Marketing365 để cập nhật xu hướng marketing mới nhất.
Đọc thêm các bài cùng chuyên mục Động thái AI.
Nguồn tham khảo
- Elon Musk just announced Grok Bot will use the best AI model for any given task
- An AI agent can pay a human to collect physical-world data
- The October 6 Fable 5.5 launch rumor turned out to be false
- Gemini 4 Argon may have broader access soon
- Gemini 4 Argon update: capabilities, access and pricing
- OpenAI unreleased model and Lean formalization claim