Nội dung
- Fable 5.2 và AI agent: sáu tín hiệu làm đổi chuẩn đánh giá
- API x402 và mô hình 3D: dữ kiện cần đối chiếu trước khi đo hiệu quả
- Benchmark, mô phỏng và doanh thu: ba thước đo đang va vào nhau
- Lời đồn về Fable 5.2 và Hy4 cần được kiểm tra trước khi dùng
- Tiếng Việt và chi phí inference: bài kiểm tra cho thị trường Việt Nam
- Bảng kiểm benchmark cần gắn với đầu ra trước khi mở rộng
- Nguồn tham khảo
Model AI mới không còn chỉ cạnh tranh bằng câu trả lời đẹp hay điểm benchmark. Các tín hiệu xoay quanh Fable 5.2, agent thu thập dữ liệu vật lý, phòng mô phỏng và hạ tầng inference cho thấy marketer phải đo cả việc máy hoàn thành được, chi phí bao nhiêu và đầu ra có kiểm tra được hay không.
Với doanh nghiệp Việt Nam, thay đổi này quan trọng vì ngân sách AI thường bắt đầu từ thử nghiệm nhỏ nhưng nhanh chóng chạm vào dữ liệu khách hàng, quy trình nội dung và chi phí API. Đo sai sẽ khiến đội ngũ chọn model theo cảm giác thay vì theo giá trị kinh doanh.
Điểm chính
- Benchmark và hình ảnh ấn tượng không đủ để chứng minh model phù hợp với một quy trình marketing.
- Đầu ra phải được đo cùng chi phí inference, thời gian hoàn thành, độ chính xác và số lần cần con người sửa.
- Dữ liệu ngoài đời, mô phỏng và agent thanh toán qua API mở rộng phạm vi công việc AI có thể tham gia.
- Marketer Việt nên bắt đầu bằng một bảng kiểm nhỏ gắn với dữ liệu tiếng Việt và điểm duyệt rõ ràng.
Fable 5.2 và AI agent: sáu tín hiệu làm đổi chuẩn đánh giá
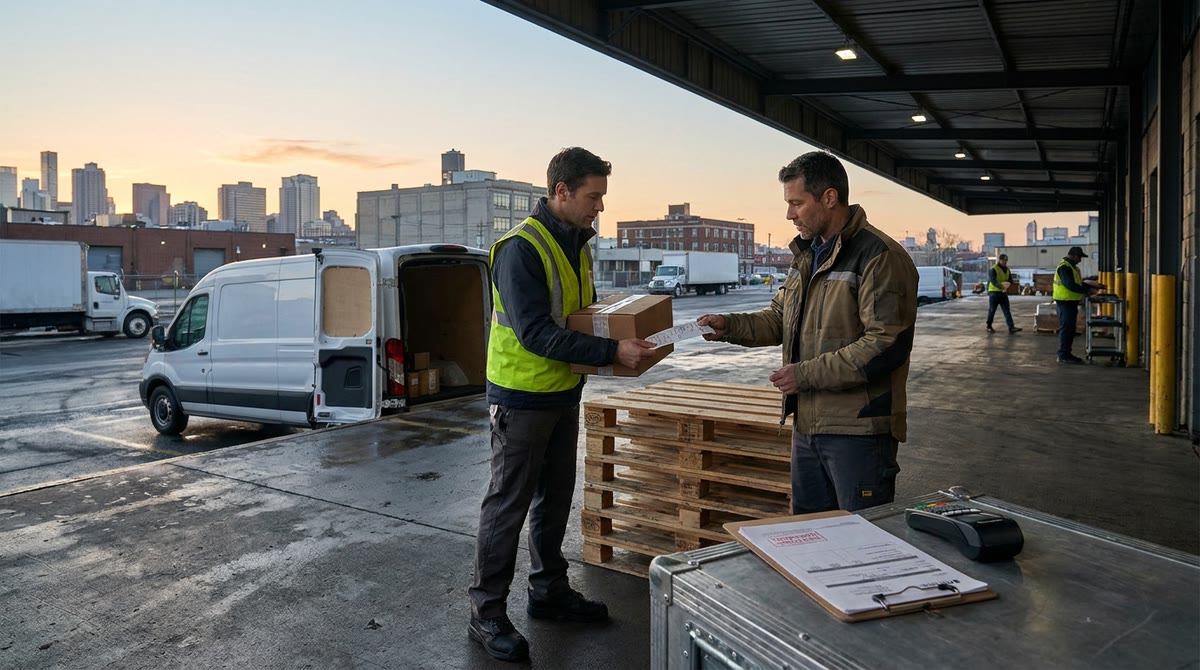
Chuỗi bài đăng được cung cấp đặt cạnh nhau hai hướng phát triển. Một hướng tập trung vào đầu ra hình ảnh có đồ họa, môi trường và ray tracing được mô tả là rất chân thực trong bài của Tobi. Hướng còn lại đưa agent ra khỏi cửa sổ chat: agent gửi yêu cầu cho người ở hiện trường, đặt ngân sách, thời hạn và nhận mô hình 3D sau khi nghiệm thu, như mô tả của Augustine.
Cùng lúc, một bài đăng về ZYQORVEXA AI đề xuất các phòng mô phỏng cho an ninh mạng, agent, quyết định kinh doanh và xác minh kỹ năng; còn bài đăng của CoinAsia nói Tencent chọn Chutes làm đối tác launch cho Hy4 với mức giá inference cụ thể. Những ví dụ này chưa đủ để xác nhận sản phẩm đã đạt chất lượng thương mại, nhưng chúng cho thấy đơn vị đo đang rời khỏi câu hỏi “model trả lời hay không” để chuyển sang “hệ thống hoàn thành việc thế nào”.
API x402 và mô hình 3D: dữ kiện cần đối chiếu trước khi đo hiệu quả
Khối này chỉ ghi nhận những chi tiết kỹ thuật được các bài đăng nêu rõ. Chúng cần được kiểm tra lại trên tài liệu chính thức trước khi đưa vào kế hoạch mua công cụ hoặc cam kết KPI.
x402 và USDC: công việc ngoài đời phải có ngân sách riêng
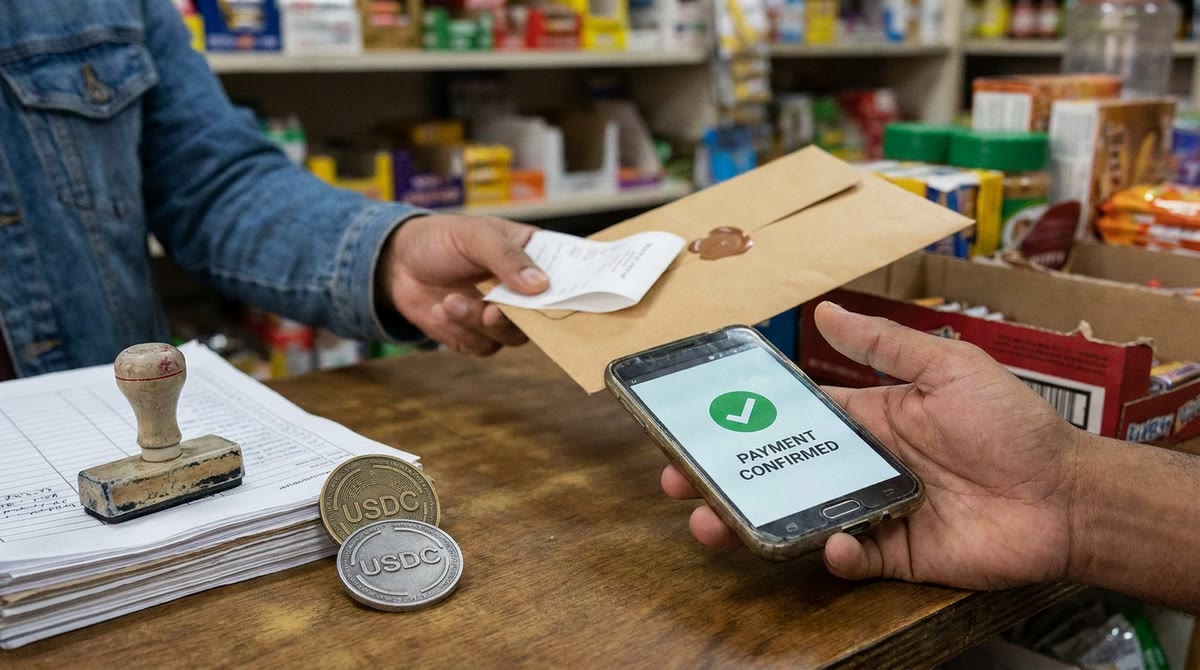
Bài đăng của Augustine mô tả agent có thể gọi API, nêu yêu cầu, đặt ngân sách và thời hạn, sau đó thanh toán USDC qua x402 trên Base hoặc Arc. Điểm marketer cần quan tâm không phải token nào được dùng, mà là mỗi tác vụ vật lý trở thành một khoản chi có điều kiện nghiệm thu. Đây là cách đo khác với chi phí prompt đơn thuần.
Chutes và Hy4: giá token phải đi cùng chất lượng đầu ra
CoinAsia nêu mức 0,525 USD cho một triệu token đầu vào và 1,5625 USD cho một triệu token đầu ra tại Chutes. Con số này chỉ có ý nghĩa khi đặt cạnh tỷ lệ lỗi, số lượt chạy lại, thời gian chờ và số giờ biên tập viên phải sửa. Giá API thấp không tự động tạo ra chi phí thấp.
Phòng mô phỏng AI: bài kiểm tra phải gần với việc thật
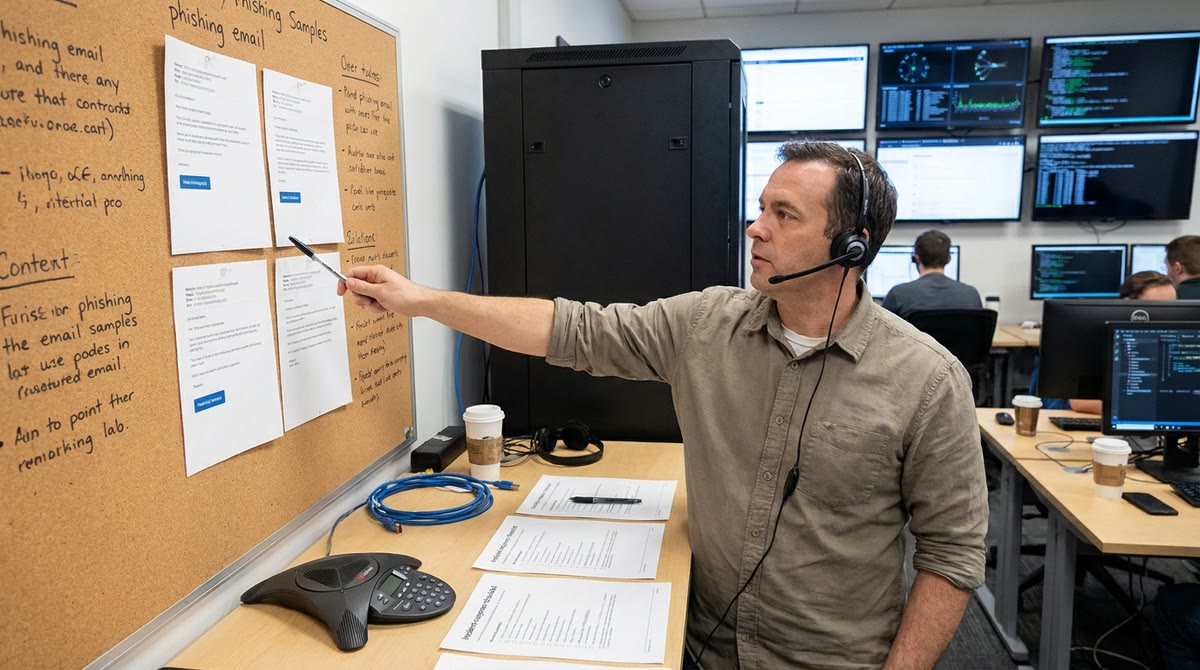
Bài đăng về ZYQORVEXA AI mô tả các bài kiểm tra phishing, phản ứng sự cố, thương lượng khách hàng và so sánh model. Ý tưởng này bổ sung cho mô tả agent thu thập không gian thật của Augustine: một bên tạo môi trường có thể lặp lại, bên kia kiểm tra khả năng xử lý dữ liệu mà phần mềm không tự nhìn thấy. Marketer có thể dùng cả hai để tách lỗi do model khỏi lỗi do dữ liệu đầu vào.
Benchmark, mô phỏng và doanh thu: ba thước đo đang va vào nhau
Độ chân thực hình ảnh không thay thế tỷ lệ hoàn thành brief
Bài đăng của Tobi nhấn vào đồ họa, môi trường và ray tracing của Fable 5.2, trong khi bài về ZYQORVEXA AI nói tới việc kiểm tra agent bằng các tình huống cụ thể. Hai tín hiệu cùng chỉ về một rủi ro: demo đẹp dễ được xem như bằng chứng năng lực tổng quát. Với marketing, chỉ số nên là tỷ lệ brief đạt yêu cầu ngay lần đầu, số vòng sửa và thời gian từ brief đến bản được duyệt.
Dữ liệu hiện trường làm lộ khoảng trống của model chỉ biết dữ liệu số
Augustine chỉ ra rằng bản đồ có thể không cho biết lối vào, khu vực nhận hàng hoặc cầu thang hiện tại trông ra sao. Bài đăng về phòng mô phỏng lại đặt agent vào các tình huống an ninh và kinh doanh có điều kiện rõ. Kết hợp hai ví dụ, có thể thấy độ chính xác phụ thuộc vào cách thu thập context trước khi chạy model. Doanh nghiệp nên ghi riêng lỗi thiếu dữ liệu, lỗi suy luận và lỗi thực thi thay vì gộp tất cả thành “AI trả lời sai”.
Chi phí inference chỉ có giá trị khi nối với đầu ra kinh doanh
Mức giá Chutes được nêu trong bài CoinAsia và cơ chế ngân sách theo tác vụ trong bài Augustine gợi ra cùng một cách tính: chi phí phải gắn với đơn vị hoàn thành. Đơn vị đó có thể là một video được duyệt, một lead được phân loại đúng, một điểm bán được dựng mô hình 3D hoặc một kịch bản chăm sóc khách hàng vượt qua kiểm thử. Dashboard chỉ ghi token sẽ không cho biết AI có tạo ra doanh thu hay giảm giờ làm hay không.
Lời đồn về Fable 5.2 và Hy4 cần được kiểm tra trước khi dùng
Fable 5.2 có đủ tin cậy để đổi model sản xuất không?
Đang lan truyền các mô tả rất tích cực về Fable 5.2 và so sánh bất lợi với “Gemini Carbon” trong các bài đăng của Tobi và Will {AI}. Đây là lời kể trên X; dữ liệu được cung cấp không cho thấy xác nhận chính thức, benchmark độc lập hay tài liệu kỹ thuật từ Anthropic.
Điều dùng được: Không đổi model trong quy trình sản xuất chỉ vì một demo. Hãy yêu cầu cùng một bộ brief, lưu đầu ra, chấm theo tiêu chí cố định và tính cả số vòng sửa trước khi kết luận.
Hy4 có thật sự phù hợp với quy mô doanh nghiệp không?
Bài đăng của CoinAsia nói Tencent chọn Chutes làm launch partner cho Hy4, nhưng trong dữ liệu hiện có chưa có thông báo chính thức hoặc tài liệu API để xác minh đầy đủ. Mức giá được nêu cũng là một tuyên bố cần đối chiếu, không phải cam kết chi phí cho mọi khách hàng.
Điều dùng được: Tách giá niêm yết khỏi tổng tiền thực tế. Trước khi thử, hãy hỏi về giới hạn tốc độ, vùng lưu dữ liệu, SLA, quyền dùng đầu ra và chi phí khi phải chạy lại.
Tiếng Việt và chi phí inference: bài kiểm tra cho thị trường Việt Nam
Ở Việt Nam, bài toán không chỉ là chọn model có demo đẹp. Dữ liệu tiếng Việt, tên riêng, tiếng địa phương, quy tắc ngành và cách khách hàng phản hồi có thể làm thay đổi tỷ lệ lỗi. Một model có giá token thấp nhưng cần nhiều biên tập viên sửa vẫn có thể đắt hơn model giá cao hơn nhưng đạt chuẩn ngay từ đầu.
Đội marketing nên tạo một tập kiểm thử từ brief thật: quảng cáo, landing page, chatbot, phân loại lead và báo cáo hiệu quả. Mỗi mẫu cần có đáp án hoặc tiêu chí chấm trước. Khi thử model, hãy ghi token, thời gian, số lượt chạy lại, số lỗi thông tin và số phút con người phải sửa. Với agent chạm vào hệ thống hoặc dữ liệu ngoài đời, điểm duyệt phải nằm trước bước gửi đi, thanh toán hoặc cập nhật CRM.
Bảng kiểm benchmark cần gắn với đầu ra trước khi mở rộng
- Chọn một quy trình nhỏ có đầu ra rõ, chẳng hạn tạo biến thể quảng cáo hoặc phân loại lead, thay vì thử model trên mọi việc cùng lúc.
- Đặt bốn cột đo: tỷ lệ đạt chuẩn, số vòng sửa, thời gian hoàn thành và tổng tiền thực tế phải bỏ ra cho mỗi đầu ra.
- Chạy cùng một bộ dữ liệu tiếng Việt qua ít nhất hai model; lưu prompt, phiên bản, đầu ra và lý do loại để có thể so sánh công bằng.
- Chỉ cho agent tự gửi, thanh toán hoặc ghi vào hệ thống sau khi có điểm duyệt và cách hoàn tác rõ ràng.
Xem thêm phân tích & hướng dẫn marketing tại https://marketing365.vn.
Theo dõi thêm các bài phân tích từ Marketing365 để cập nhật xu hướng marketing mới nhất.
Đọc thêm các bài cùng chuyên mục Động thái AI.
Nguồn tham khảo
- Anthropic just released their newest model Fable 5.2 and it’s actually very insane. an engineer made this but… — Tobi
- Logan closed replies because new Gemini Carbon officially MOGGED by freshly released Fable 5.2 — Will {AI}
- there’s a limit to how much an AI agent can understand about the physical world… — Augustine
- KAV is the Alien of Solana… The Future of Intelligent Simulations, AI TestLabs & the Creator Economy
- Tencent… has selected Chutes, a Bittensor subnet, as a launch partner for its new flagship AI model, Hy4