Nội dung
- Từ Laya đến Vangrid: mô hình AI mới bị kéo về bài toán làm việc thật
- Những phần vừa đổi quanh mô hình AI mới — chạm tới cách chọn công cụ
- Tổng tiền thực tế của model AI gồm cả lỗi chạy và dữ liệu đầu vào
- Gói ChatGPT Pro Max 500 USD chưa đủ cơ sở để lập ngân sách
- Người mua mô hình AI mới ở Việt Nam cần tính cả dữ liệu tiếng Việt
- Đặt ngưỡng chi và người duyệt trước khi mở rộng model AI
- Nguồn tham khảo
Mô hình AI mới không còn chỉ cạnh tranh bằng điểm benchmark hay mức giá mỗi lượt dùng. Từ model open-source có điểm quyết định được công bố, agent thuê người thu thập dữ liệu ngoài đời đến những phàn nàn về giới hạn sử dụng, giá trị thực đang chuyển sang khả năng hoàn tất việc với chi phí kiểm soát được. Với marketer Việt Nam, thay đổi này ảnh hưởng trực tiếp tới cách chọn công cụ, chia ngân sách và duyệt đầu ra.
Điểm chính
- Giá trị của model AI được kéo từ điểm benchmark về kết quả công việc và độ ổn định khi chạy dài.
- Dữ liệu không gian thực tế trở thành một khoản đầu vào mà agent có thể chủ động đặt mua.
- Ngân sách cần tính cả thời gian giám sát, lượt chạy lỗi và chi phí mua dữ liệu, không chỉ phí thuê bao.
- Doanh nghiệp Việt nên kiểm thử bằng workflow tiếng Việt và chốt điểm dừng trước khi mở rộng.
Từ Laya đến Vangrid: mô hình AI mới bị kéo về bài toán làm việc thật
Câu chuyện về Nandakishor M cho thấy một hướng cạnh tranh khác ngoài cuộc đua của các phòng lab lớn. Theo bài đăng của Felix Josemon, Laya là model open-source do một kỹ sư xuất thân từ làng nhỏ ở Kerala xây dựng; model này được giới thiệu là cạnh tranh với Jev của TypeSafe về tốc độ và điểm số quyết định được công bố. Dù chưa có bộ kiểm thử độc lập trong dữ liệu được cung cấp, chi tiết đó vẫn gợi ra tiêu chí mà người mua AI quan tâm: model làm ra quyết định có thể đánh giá hay không.
Ở đầu kia của chuỗi công việc, Vangrid được mô tả là mạng thu thập video mặt đất theo yêu cầu của agent. Aliba và Haki đều nhấn mạnh cơ chế agent gửi bounty, trả USDC qua Base và nhận mô hình 3D đã gắn hash, vị trí gần đúng cùng thời điểm ghi hình. Hai diễn biến này cùng chỉ về một hướng: model không đứng riêng trong chatbot; nó cần dữ liệu, công cụ và một cách kiểm tra đầu ra để hoàn thành nhiệm vụ.
Những phần vừa đổi quanh mô hình AI mới — chạm tới cách chọn công cụ
Khối cập nhật dưới đây chỉ ghi nhận các khả năng được mô tả trực tiếp trong nguồn. Những lời kể về chất lượng hoặc kế hoạch thương mại chưa đủ cơ sở sẽ được tách riêng ở phần sau.
Điểm quyết định được công bố của Laya: thêm một tiêu chí ngoài benchmark
Laya là một model open-source được giới thiệu cùng điểm số về khả năng ra quyết định và tốc độ so với Jev. Với đội marketing, giá trị của thông tin này nằm ở việc mở thêm một bài test: không chỉ hỏi model viết hay, mà kiểm tra model chọn bước tiếp theo có đúng điều kiện, đúng dữ liệu và đúng giới hạn đã đặt hay không. Nguồn tham chiếu là bài đăng của Felix Josemon.
Bounty agent-native của Vangrid: dữ liệu hiện trường thành khoản mua theo nhu cầu
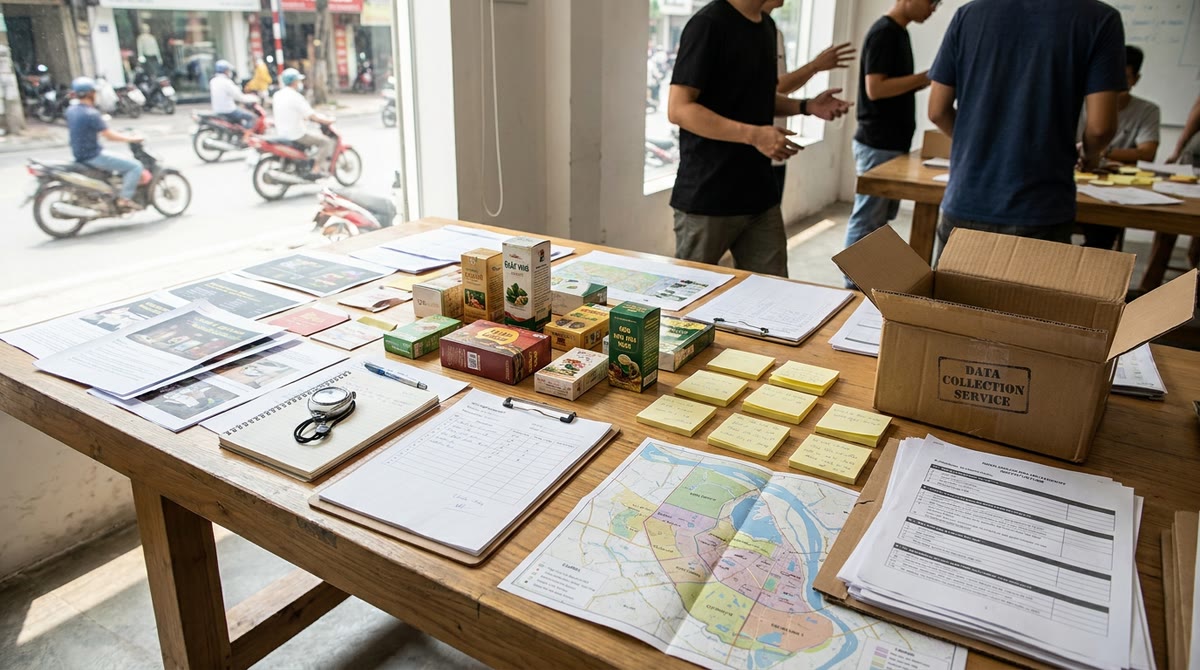
Vangrid cho phép agent gửi yêu cầu quay một địa điểm, thanh toán qua x402 bằng USDC trên Base và nhận mô hình 3D qua API. Hệ thống được mô tả là băm nội dung, ghi vị trí gần đúng và thời điểm, đồng thời làm mờ khuôn mặt và biển số trên thiết bị. Điều này chạm tới các đội cần dữ liệu địa điểm, hình ảnh cửa hàng hoặc không gian trưng bày: ngân sách dữ liệu có thể gắn với từng nhiệm vụ thay vì mua một kho dữ liệu lớn ngay từ đầu. Xem mô tả tại Haki.
Tổng tiền thực tế của model AI gồm cả lỗi chạy và dữ liệu đầu vào
Chi phí giám sát tăng khi agent chạy dài, dù giá mỗi lượt dùng có thể thấp
Phàn nàn của một người dùng Codex cho biết agent bị dừng bởi lỗi máy chủ, tài khoản gặp giới hạn và model tiêu hao hạn mức nhanh hơn công cụ đối chiếu trong trải nghiệm cá nhân của người viết. Đây là lời kể người dùng, không phải phép đo độc lập. Tuy vậy, đặt cạnh cơ chế Vangrid phải trả tiền để người thật thu thập góc nhìn cụ thể, ta thấy cùng một khoản chi thường bị bỏ quên: thời gian xử lý khi đầu vào thiếu, agent dừng hoặc đầu ra phải làm lại. Marketer nên tính số lần con người can thiệp và số workflow thất bại vào ngân sách, thay vì chỉ lấy giá thuê bao nhân với số người dùng. Hai dẫn chứng gồm trải nghiệm được Leo chia sẻ và mô tả cơ chế Vangrid của Aliba.
Doanh thu quảng cáo bị ép sát vào phí phân phối khi agent chọn nơi mua
Phân tích của Freda Duan đặt ra rủi ro agentic commerce làm giảm vai trò của nền tảng ở đầu phễu: người bán vẫn phải trả tiền để được phân phối, nhưng khoản đó có thể đi qua quảng cáo hoặc tỷ lệ trên giao dịch. Khi ghép với mô hình bounty của Vangrid, cùng một logic trở nên rõ hơn: bên sở hữu nhu cầu trả tiền cho khả năng đưa đúng dữ liệu hoặc đúng hàng hóa tới agent, thay vì chỉ mua lượt hiển thị. Vì vậy, marketer cần theo dõi chi phí cho mỗi kết quả được agent chọn, không chỉ CTR hay số lượt tiếp cận. Dẫn chứng là phân tích của Freda Duan và mô tả API bounty của Haki.
Đầu ra có thể kiểm tra quyết định phần ngân sách dành cho con người
Laya được gắn với điểm số quyết định, còn dữ liệu Vangrid được gắn hash, vị trí gần đúng và thời gian. Hai cách này chưa chứng minh cùng một chuẩn chất lượng, nhưng cho thấy doanh nghiệp sẽ phải trả tiền cho việc kiểm tra đầu ra: bài test, người duyệt, log và dữ liệu nguồn. Khoản này có thể lớn hơn phần chênh lệch giữa hai model nếu workflow liên quan đến thương hiệu, giá bán hoặc thông tin khách hàng. Cơ sở của nhận định gồm thông tin về Laya và cơ chế xác thực dữ liệu Vangrid.
Gói ChatGPT Pro Max 500 USD chưa đủ cơ sở để lập ngân sách
Mức thuê bao cao có phải là cách mua thêm độ ổn định không?
Đang lan truyền một dự đoán rằng OpenAI chuẩn bị gói ChatGPT Pro Max giá 500 USD mỗi tháng và có thể giới thiệu tại DevDay. Đây là thông tin chưa được OpenAI xác nhận, được đăng bởi Codex News; nguồn không cung cấp tài liệu sản phẩm chính thức. Điều dùng được: đội marketing không nên đưa khoản 500 USD vào kế hoạch chi tiêu cho tới khi có trang giá, giới hạn, điều khoản dữ liệu và kết quả kiểm thử. Hãy so sánh tổng tiền thực tế gồm phí thuê bao, số lượt chạy lỗi và thời gian người duyệt phải bỏ ra.
Người mua mô hình AI mới ở Việt Nam cần tính cả dữ liệu tiếng Việt
Doanh nghiệp Việt không nên suy ra chất lượng từ tốc độ hoặc điểm số được công bố trong bối cảnh khác. Workflow marketing thường chứa tiếng Việt, tên địa phương, cách viết giá, quy định nội bộ và dữ liệu khách hàng. Những yếu tố này quyết định model có làm được việc hay chỉ tạo thêm vòng sửa.
Vangrid cho thấy dữ liệu ngoài đời có thể được đặt mua theo địa điểm; Laya cho thấy khả năng quyết định có thể trở thành một tiêu chí công khai. Với thị trường Việt Nam, bài test nên bao gồm truy vấn tiếng Việt, ảnh cửa hàng thật, yêu cầu giữ nguyên thông tin sản phẩm và tình huống phải chuyển việc cho người duyệt. Ngân sách thử nghiệm cần tách riêng cho model, dữ liệu và kiểm tra đầu ra. Không có bằng chứng trong các nguồn cho thấy những sản phẩm trên đã sẵn sàng phục vụ doanh nghiệp Việt, nên đây là khung đánh giá chứ không phải khuyến nghị mua.
Đặt ngưỡng chi và người duyệt trước khi mở rộng model AI
- Chọn một workflow có đầu ra đo được, chẳng hạn phân loại brief, tạo biến thể quảng cáo hoặc kiểm tra thông tin sản phẩm.
- Lập bảng chi phí gồm phí model, lượt chạy lỗi, dữ liệu bổ sung và thời gian người duyệt.
- Chạy cùng một bộ prompt tiếng Việt trên ít nhất hai công cụ; ghi lại tỷ lệ phải sửa và điểm dừng khi model trả lời thiếu căn cứ.
- Chỉ tăng ngân sách khi đầu ra đạt ngưỡng đã chốt trong nhiều lần chạy và vẫn có người chịu trách nhiệm duyệt.
Xem thêm phân tích & hướng dẫn marketing tại https://marketing365.vn.
Theo dõi thêm các bài phân tích từ Marketing365 để cập nhật xu hướng marketing mới nhất.
Đọc thêm các bài cùng chuyên mục Động thái AI.
Nguồn tham khảo
- Felix Josemon giới thiệu câu chuyện xây dựng model open-source Laya
- Freda Duan phân tích tác động của agentic commerce lên quảng cáo và doanh thu nền tảng
- Leo chia sẻ trải nghiệm về độ ổn định, giới hạn và mức tiêu hao của các agent coding
- Aliba mô tả cơ chế bounty và dữ liệu không gian thực tế của Vangrid
- Codex News đăng dự đoán về gói ChatGPT Pro Max
- Haki mô tả agent thuê người thu thập dữ liệu vật lý qua Vangrid