Nội dung
- Sáu mảnh ghép mô hình AI: từ agent đến model chạy tại chỗ
- Các thay đổi trong mô hình AI — chạm tới cách marketing chọn công cụ
- Cơ chế chi phí khiến mô hình AI không còn được mua bằng điểm benchmark
- Lợi thế agent dùng Opus 5.5 vẫn chưa có xác nhận
- Thị trường Việt Nam trước mô hình AI chạy cục bộ và agent nối công cụ
- Đo chi phí theo việc hoàn tất trước khi mở rộng mô hình AI
- Nguồn tham khảo
Giá trị của mô hình AI đang tách khỏi điểm benchmark và số token được xử lý. Agent có thể tự làm nhiều bước, model chạy ngay trên thiết bị có thể giảm tiền dùng dịch vụ, còn các cách huấn luyện mới có thể rút ngắn chi phí đào tạo. Với marketer Việt Nam, câu hỏi thiết thực là ngân sách đang trả cho năng lực nào và đội ngũ kiểm tra đầu ra ra sao.
Điểm chính
- Agent biến tiền mua model thành tiền cho kết nối công cụ, quyền tự làm và kiểm tra.
- Model chạy tại chỗ mở thêm lựa chọn cho dữ liệu nhạy cảm và các tác vụ coding.
- Tốc độ hoặc điểm benchmark chỉ có ý nghĩa khi gắn với việc hoàn tất và kết quả kinh doanh.
- Đội marketing Việt nên thử trên quy trình nhỏ, đo tổng chi phí thực tế trước khi mở rộng.
Sáu mảnh ghép mô hình AI: từ agent đến model chạy tại chỗ
Các nguồn cho thấy thị trường đang đi theo nhiều hướng cùng lúc. Personal agent như Grok Bot, Muse, Claude Duet và ChatGPT Dots cạnh tranh bằng mức chủ động, voice, memory, connector và khả năng làm việc trong hệ sinh thái sẵn có, thay vì chỉ bằng tên model. Bài đánh giá của Peter Yang đặt các khác biệt này cạnh nhau; nhận xét về Claude Duet cũng nhấn mạnh khả năng chủ động và Artifacts.
Ở phía model, JOLT của Perplexity nhắm vào chi phí post-training, Gemini 4 Argon cho thấy năng lực tạo trải nghiệm 3D tương tác, còn Flint đưa coding model dạng MoE lên thiết bị cá nhân. Cùng lúc, ad stack của ChatGPT cho thấy AI trong marketing còn liên quan đến retrieval, ranking, auction và việc giữ câu trả lời độc lập.
Các thay đổi trong mô hình AI — chạm tới cách marketing chọn công cụ
Những điểm dưới đây là các năng lực đã được mô tả trực tiếp trong nguồn. Chúng không đồng nghĩa mọi doanh nghiệp đều nên triển khai ngay.
Personal agent: đội marketing phải kiểm tra cả hành động sau câu trả lời
Personal agent kết nối email, browser, cloud hoặc thread nội bộ để làm nhiều bước thay người dùng. Review của Peter Yang ghi nhận khác biệt về mức chủ động, voice, Pages, Artifacts và độ ổn định giữa các agent. Với marketing, checklist không thể dừng ở chất lượng văn bản; cần ghi rõ agent được đọc gì, gửi gì và cần người duyệt ở bước nào.
JOLT: chi phí huấn luyện trở thành tiêu chí chọn model
JOLT là phương pháp post-training trong đó một model vừa đóng vai trò người dạy vừa là người học; nguồn cho biết phương pháp đạt độ chính xác trên MATH tương đương GRPO với số token huấn luyện ít hơn 6,5 lần. Đội marketing không cần sao chép kỹ thuật này, nhưng nên hỏi nhà cung cấp model dùng bao nhiêu tài nguyên để đạt chất lượng phù hợp với tác vụ.
Flint: model chạy tại chỗ mở lựa chọn cho coding workflow
Flint là open model khoảng 40 tỷ tham số, tập trung vào agentic coding và chạy trên thiết bị. Nguồn nêu tốc độ hơn 125 token/giây trên MacBook Pro M4 và hơn 150 token/giây trên RTX Spark trong ngữ cảnh ngắn. Điều này liên quan tới các đội marketing có martech nội bộ: họ có thể thử coding model tại chỗ, nhưng vẫn phải tính tiền phần cứng, bảo trì và kiểm tra mã.
Ad stack và 3D visualization: đầu ra AI mở rộng từ chữ sang trải nghiệm
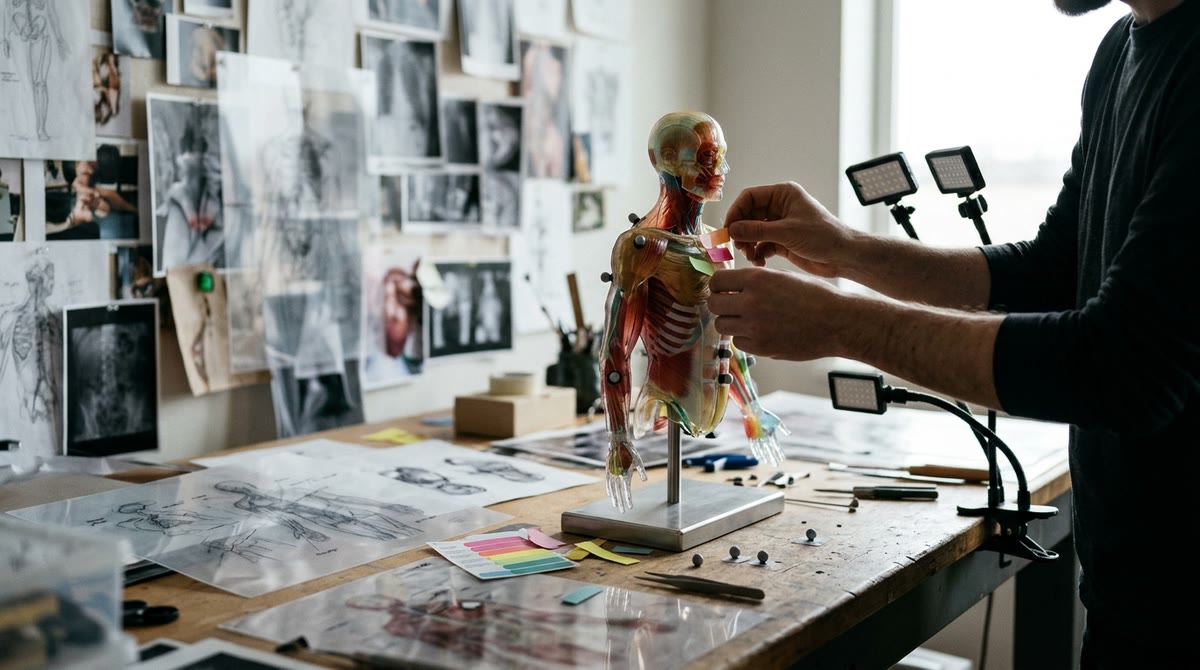
Ad stack của ChatGPT mô tả cách LLM orchestrator, retrieval, ranking và auction phối hợp trong quảng cáo. Gemini 4 Argon được dùng để tạo mô hình giải phẫu 3D có thể bật tắt lớp dữ liệu và xem chuyển động. Hai ví dụ cho thấy marketer phải đánh giá cả pipeline tạo trải nghiệm, không chỉ câu trả lời của model.
Cơ chế chi phí khiến mô hình AI không còn được mua bằng điểm benchmark
Chi phí hoàn tất việc thay cho giá mỗi lượt gọi
Agent tạo thêm giá trị khi tự đi qua nhiều bước, nhưng mỗi connector, lần truy xuất và lần sửa sai đều có thể phát sinh chi phí. Review về các personal agent cho thấy mức chủ động và khả năng nối công cụ khác nhau; Flint lại cho thấy một model local có thể xử lý coding với tốc độ cao trên phần cứng cá nhân. Vì vậy, phép tính nên là tổng tiền để hoàn tất một campaign asset, báo cáo hoặc script, gồm tiền model, phần cứng và thời gian kiểm tra.
Quyền tự làm kéo ngân sách kiểm tra lên
Claude Duet được mô tả là chủ động hơn, trong khi Grok Bot, Muse và ChatGPT Dots có các giới hạn riêng về email, browser hoặc độ ổn định (Peter Yang). Nhận xét của Chris còn đặt câu hỏi về việc dùng Opus 5.5 qua Grok Bot so với agent chính chủ. Hai nguồn cùng gợi ra một cơ chế: càng cho máy tự làm nhiều, doanh nghiệp càng phải chi cho log, phê duyệt, test và xử lý lỗi.
Tốc độ đầu ra chỉ có giá trị khi nối được với kết quả
JOLT nói về việc giảm token huấn luyện, Flint nói về tốc độ chạy local, còn ad stack của ChatGPT nói về ranking và auction. Ba hướng này đều chuyển sự chú ý từ “model nào mạnh hơn” sang “quy trình nào hoàn tất nhanh hơn và đo được”. Marketing nên nối thời gian xử lý với CTR, tỷ lệ chuyển đổi, số giờ tiết kiệm hoặc doanh thu; không nên dùng tốc độ token làm KPI cuối cùng.
Lợi thế agent dùng Opus 5.5 vẫn chưa có xác nhận
Dùng cùng Opus 5.5 có khiến các agent giống nhau?
ChrisGPT phỏng đoán rằng Grok Bot dùng Claude Opus 5.5 sẽ kém hấp dẫn hơn agent chính chủ nếu Anthropic cung cấp memory, skills, connectors và môi trường thực thi được tối ưu riêng. Đây là nhận xét cá nhân; các bên trong nguồn chưa xác nhận một kết luận so sánh toàn diện. Điều dùng được: đội marketing nên thử cùng một workflow trên từng agent, ghi lại số bước lỗi, thời gian người duyệt và quyền dữ liệu, thay vì suy ra chất lượng chỉ từ tên model.
Thị trường Việt Nam trước mô hình AI chạy cục bộ và agent nối công cụ
Doanh nghiệp Việt thường không thiếu công cụ thử nghiệm nhưng thiếu dữ liệu sạch, quy trình rõ và người chịu trách nhiệm khi máy làm sai. Model chạy tại chỗ như Flint có thể phù hợp với mã nguồn hoặc dữ liệu không muốn đưa lên dịch vụ ngoài, song tổng tiền thực tế vẫn gồm máy, cập nhật, vận hành và kiểm thử. Agent nối email, CRM hoặc kho tài liệu lại đặt trọng tâm vào quyền truy cập và tiếng Việt trong dữ liệu nội bộ.
Vì vậy, lựa chọn hợp lý không phải “cloud hay local” cho toàn công ty. Hãy chia theo tác vụ: nội dung công khai có thể dùng dịch vụ cloud; mã, dữ liệu khách hàng hoặc tài liệu nhạy cảm cần quy trình riêng; các trải nghiệm 3D hay quảng cáo cần thêm bước kiểm tra brand safety và tính chính xác.
Đo chi phí theo việc hoàn tất trước khi mở rộng mô hình AI
- Chọn một workflow cụ thể, chẳng hạn tạo landing page hoặc tổng hợp insight, rồi ghi đủ tiền model, connector, phần cứng và giờ kiểm tra.
- Đặt mức agent được tự làm tới đâu: đọc dữ liệu, đề xuất hay được gửi trực tiếp; mọi bước vượt mức phải có người duyệt.
- Chạy cùng một workflow trên một agent cloud và một model local nếu dữ liệu cho phép; so sánh chất lượng, thời gian và tổng tiền thực tế.
- Gắn đầu ra với KPI kinh doanh như CTR, conversion rate, số giờ tiết kiệm hoặc doanh thu trước khi tăng ngân sách.
Xem thêm phân tích & hướng dẫn marketing tại https://marketing365.vn.
Theo dõi thêm các bài phân tích từ Marketing365 để cập nhật xu hướng marketing mới nhất.
Đọc thêm các bài cùng chuyên mục Động thái AI.
Nguồn tham khảo
- Peter Yang — Updated review of personal agents
- ChrisGPT — Claude Opus 5.5, Grok Bot and Claude Duet
- Perplexity — JOLT post-training method
- Google DeepMind — Gemini 4 Argon interactive anatomy visualization
- OpenAI Developers — ChatGPT ad stack
- Ollama — Flint open model for agentic coding