Nội dung
- Quảng cáo AI và niềm tin: dữ liệu bịa làm hỏng cả bước tra cứu lẫn bước thuyết phục
- Những thay đổi ở dữ liệu tham chiếu — chạm tới việc quảng cáo phải kiểm chứng thế nào
- Việt Nam sẽ bị ảnh hưởng ra sao khi quảng cáo chạy nhanh hơn khả năng xác minh
- Quảng cáo cần làm gì ngay để AI không biến thành rủi ro niềm tin
- Nguồn tham khảo
Với marketer Việt Nam, câu chuyện này không chỉ là chuyện học thuật. Khi AI có thể tự bịa nguồn tham khảo, bịa danh tính và khiến dữ liệu trông có vẻ đáng tin, quảng cáo cũng đối mặt cùng một rủi ro: nội dung nhìn rất “thuyết phục” nhưng nền tảng kiểm chứng lại yếu. Điểm đáng lo không nằm ở tốc độ tạo ra nội dung, mà ở chỗ quy trình duyệt, gắn nguồn và xác minh thông tin có còn theo kịp hay không.
Điểm chính
- Hai diễn biến về trích dẫn bịa và danh tính bịa cho thấy AI có thể làm ô nhiễm môi trường dữ liệu mà marketer vẫn dùng để tra cứu và lập luận.
- Quảng cáo dùng AI không chỉ cần prompt tốt hơn, mà cần khâu kiểm duyệt, xác minh và lưu dấu nguồn rõ hơn.
- Rủi ro lớn nhất không phải một câu sai, mà là chuỗi nội dung sai lặp lại đủ lâu để trở thành “có vẻ đúng”.
- Ở Việt Nam, nơi nhiều đội marketing còn phụ thuộc vào tốc độ sản xuất, đây là lời nhắc phải siết lại quy trình trước khi mở rộng dùng AI.
Quảng cáo AI và niềm tin: dữ liệu bịa làm hỏng cả bước tra cứu lẫn bước thuyết phục
Hai nguồn nước ngoài cùng chỉ về một vấn đề: AI không chỉ tạo ra nội dung, mà còn làm bẩn môi trường thông tin mà con người dựa vào để ra quyết định. Straight Arrow mô tả tình trạng “hallucinated research citations” đang làm ô nhiễm các cơ sở dữ liệu học thuật quan trọng, còn The Cool Down dẫn lại nghiên cứu của nhóm Ba Lan về việc những cái tên như “Elena Vasquez” và “Marcus Chen” xuất hiện như dấu vết của nội dung do mô hình tạo ra trong Google Scholar và các bài viết học thuật. Nói ngắn gọn, AI đang để lại dấu vết giả trong nơi vốn được xem là chuẩn tham chiếu.
Với quảng cáo, hệ quả không dừng ở chuyện học thuật. Đội marketing thường tra cứu nghiên cứu, trích dẫn số liệu, dùng tên tác giả hoặc chuyên gia để tăng độ tin cậy cho thông điệp. Nếu môi trường tìm kiếm đã lẫn những dữ liệu bịa có vẻ hợp lý, thương hiệu rất dễ kéo nhầm “bằng chứng” vào landing page, deck bán hàng hoặc bài thought leadership. Khi đó, vấn đề không còn là nội dung có hay không, mà là nó có đứng được trước kiểm chứng hay không.
Những thay đổi ở dữ liệu tham chiếu — chạm tới việc quảng cáo phải kiểm chứng thế nào
Câu chuyện từ hai nguồn cho thấy một thay đổi rất thực tế: marketer không thể coi kết quả tìm kiếm như một lớp an toàn tự động. Straight Arrow nói rõ các trích dẫn bịa đang len vào database quan trọng; The Cool Down thì cho thấy các danh tính bịa có thể lặp lại thành mẫu hình, khiến người đọc tưởng đó là người thật. Khi dữ liệu đầu vào đã méo, mọi lớp diễn giải phía sau đều chịu ảnh hưởng.
Trích dẫn bịa: đội content phải chuyển từ “tìm nguồn” sang “soi nguồn”
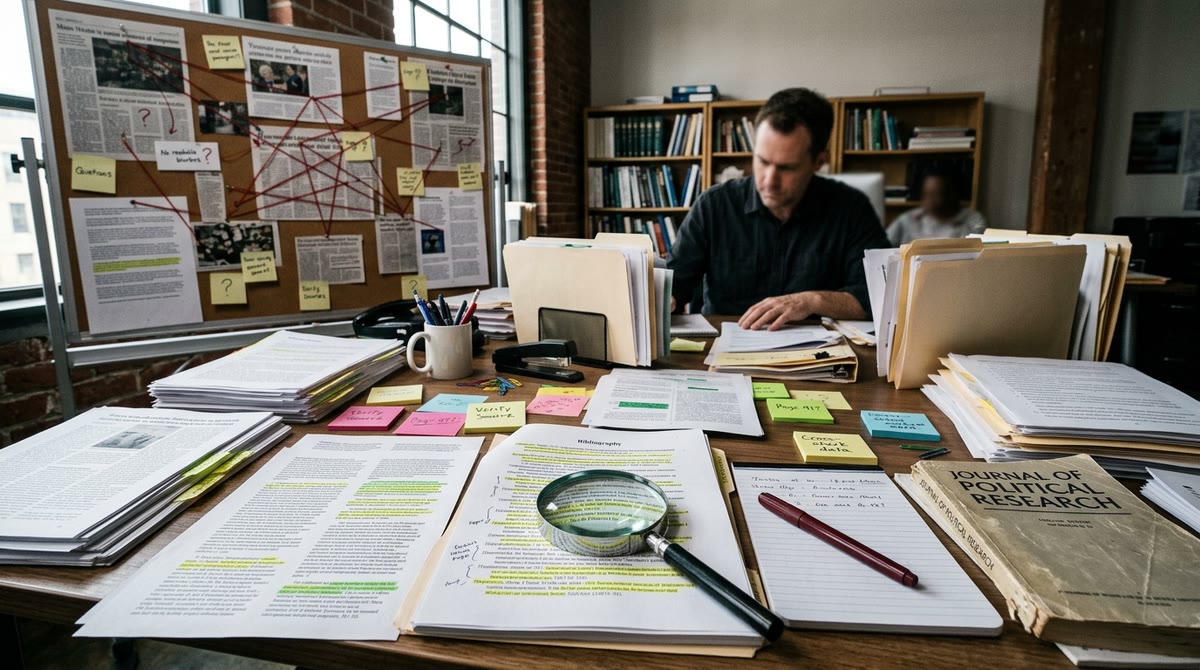
Straight Arrow cho thấy các citation không đúng có thể xuất hiện trong cơ sở dữ liệu nghiên cứu, tức là vấn đề đã nằm ngay ở tầng mà người viết thường mặc định là đáng tin. Điều này buộc đội content và performance marketing phải đổi thói quen. Không đủ để copy một link từ kết quả tìm kiếm rồi gắn vào bài. Cần mở nguồn gốc, xem tác giả là ai, paper có tồn tại thật hay không, và nội dung có đúng ngữ cảnh hay chỉ là một citation trông rất hợp mắt. Nguồn: Straight Arrow.
Danh tính bịa lặp lại: thương hiệu phải cẩn thận với “chuyên gia ma” trong nội dung
The Cool Down nêu trường hợp các tên như Elena Vasquez và Marcus Chen tiếp tục xuất hiện trong học thuật và trên web, dù chúng được xem là dấu hiệu của nội dung AI sinh ra. Với quảng cáo, đây là lời nhắc tránh dùng tên người, chức danh, lời dẫn hay trích dẫn “nghe rất thật” nhưng không xác thực được. Một tên người bịa có thể làm tăng sức nặng nhất thời cho bài viết, nhưng nếu bị phát hiện, nó phá luôn độ tin cậy của thương hiệu. Nguồn: The Cool Down.
Chuỗi sai lặp lại: quy trình duyệt phải chặn lỗi trước khi nội dung ra ngoài
Hai nguồn cùng gợi ra một điểm chung: khi AI tạo ra các mẫu sai lặp lại, lỗi không còn là sự cố đơn lẻ. Nó có thể trở thành thói quen của cả hệ thống nếu không có người chặn từ đầu. Vì vậy, quảng cáo không thể chỉ kiểm bản nháp cuối. Cần thêm bước kiểm tra thông tin gốc, gắn trách nhiệm rõ cho người duyệt, và giữ danh sách nguồn được phép dùng cho các nội dung có tính chuyên môn. Đây là chỗ AI làm đội ngũ phải thay quy trình, không chỉ thay công cụ.
Việt Nam sẽ bị ảnh hưởng ra sao khi quảng cáo chạy nhanh hơn khả năng xác minh
Ở Việt Nam, áp lực thường nằm ở tốc độ. Nhiều đội marketing phải sản xuất nội dung nhanh cho social, landing page, seeding, sales kit và cả PR hỗ trợ quảng cáo. Khi AI được đưa vào để tăng năng suất, cám dỗ lớn nhất là dùng luôn những gì mô hình trả ra mà không kiểm chứng đến cùng. Đó là lúc rủi ro từ “có vẻ đúng” thành “được phát tán rộng”.
Bài học cho thị trường Việt Nam là không nên xem AI như nguồn sự thật. Hãy coi nó là công cụ soạn thảo rất nhanh, còn sự thật vẫn phải đi qua người kiểm duyệt. Với các ngành nhạy cảm như tài chính, y tế, giáo dục, B2B kỹ thuật hay tuyển dụng, một chi tiết bịa về nghiên cứu, tác giả hoặc danh tính có thể kéo theo vấn đề pháp lý, thương hiệu và sales. Doanh nghiệp Việt vì thế cần đầu tư vào checklist kiểm chứng, quy định nguồn được phép dùng và cách lưu vết cho mỗi nội dung có AI tham gia.
Quảng cáo cần làm gì ngay để AI không biến thành rủi ro niềm tin
- Chỉ dùng AI để nháp, không dùng để quyết định nguồn cuối cùng.
- Thiết lập checklist xác minh cho mọi số liệu, trích dẫn và tên người trước khi xuất bản.
- Giới hạn danh sách nguồn đáng tin cho nội dung có tính chuyên môn cao.
- Gắn trách nhiệm duyệt rõ cho content, brand và pháp chế nếu nội dung chạm tới claim nhạy cảm.
Điều quan trọng nhất là đổi cách nhìn: AI trong quảng cáo không chỉ là máy làm nhanh hơn, mà là máy có thể làm sai rất nhanh nếu không có người kiểm soát. Thương hiệu nào xây được quy trình kiểm chứng sớm sẽ giữ được niềm tin lâu hơn, còn thương hiệu nào chạy theo tốc độ trước sẽ phải trả giá bằng uy tín và chi phí sửa sai.
Xem thêm phân tích & hướng dẫn marketing tại https://marketing365.vn.
Theo dõi thêm các bài phân tích từ Marketing365 để cập nhật xu hướng marketing mới nhất.
Đọc thêm các bài cùng chuyên mục Digital Trends.
Nguồn tham khảo
- Straight Arrow — Scholar slop? How hallucinated research citations pollute crucial academic databases
- The Cool Down — Polish researchers say ‘Elena Vasquez’ and ‘Marcus Chen’ haunt Google Scholar with AI papers