Nội dung
Giữa tháng 7/2026 tôi bắt tay vào việc gắn link nội bộ cho marketing365.vn — nối các bài tin về những trang giải nghĩa kiểu AI Agent là gì, “OpenAI là gì”. Việc này nghe đơn giản đến mức tôi làm luôn, không dừng lại kiểm tra gì cả.
Kết quả: con số mở đầu là con số sai, quy tắc gắn link tự động thì sai đều trên 412 bài, và tôi suýt làm hỏng lần thứ ba nữa. Bài này ghi lại cả ba nước đi hỏng theo đúng thứ tự, cùng số đo lại ngay hôm nay để bạn kiểm được.
Con số 479 và chỗ tôi đếm sai
Bước đầu tiên là tìm xem bài nào đang “mồ côi” — không có bài nào khác trỏ tới. Tôi viết một câu truy vấn đếm số thẻ liên kết nằm trong post_content, tức là phần nội dung lưu trong cơ sở dữ liệu. Ra 479 bài không có link nào. Nghe rất kịch tính, và tôi báo luôn con số đó.
Chỗ sai nằm ở chỗ Google không đọc cơ sở dữ liệu của tôi. Nó đọc trang HTML sau khi giao diện dựng xong. Mà giao diện thì tự chèn thêm rất nhiều liên kết: bài trước — bài sau, “Có thể bạn thích”, danh sách bài cùng chuyên mục ở cột bên, đường dẫn phân cấp trên đầu trang. Không cái nào trong số đó nằm trong post_content.
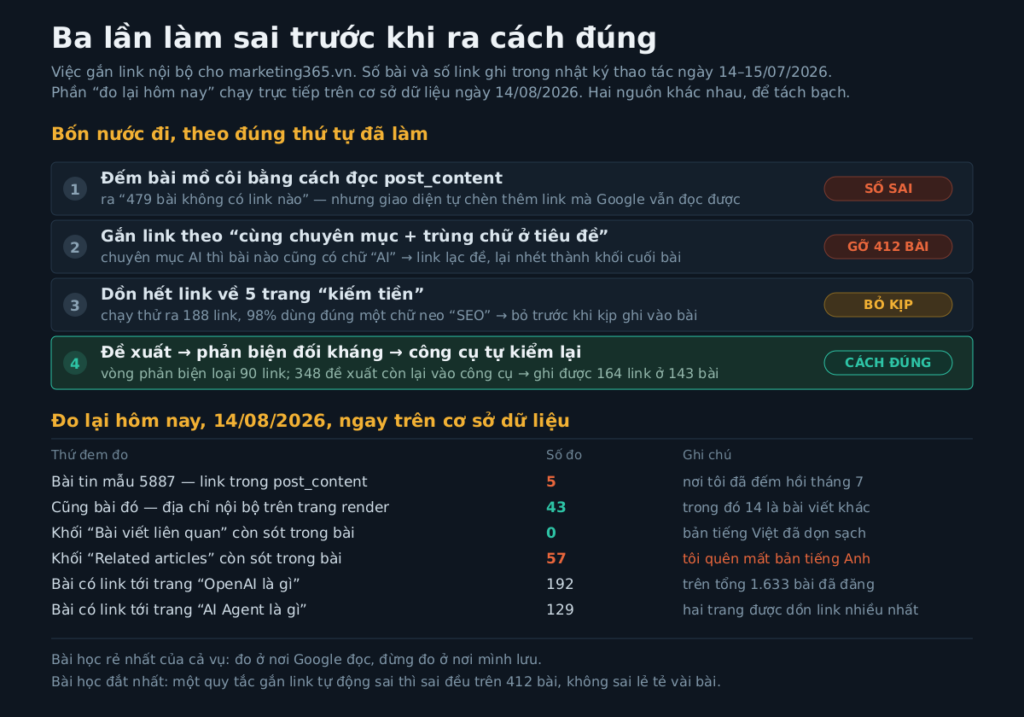
Hôm nay tôi đo lại để chắc rằng mình không nhớ nhầm. Lấy ngẫu nhiên một bài tin đang đăng — bài số 5887 trong chuyên mục Digital Trends. Trong post_content: 5 liên kết. Tải chính trang đó về rồi đếm địa chỉ nội bộ khác nhau trong HTML: 43, trong đó 14 là bài viết khác. Bài mà tôi từng có thể xếp vào nhóm “gần mồ côi” hoá ra đang được trỏ tới đầy đủ.
Đây đúng là họ lỗi tôi vừa mắc ở chuyện khác: tin vào cái mình đếm được thay vì cái máy tìm kiếm thật sự nhìn thấy. Tôi kể một lần tương tự trong bài Bốn lần tôi đoán sai nguồn CLS — ở đó là đếm số dòng grep, ở đây là đếm link trong cơ sở dữ liệu. Cùng một cái bẫy, đội hai cái mũ khác nhau.
Gắn link tự động: sai một luật, sai đều 412 bài
Chưa kịp phát hiện con số 479 sai, tôi đã chạy tiếp sang bước gắn link. Luật chọn bài đích lúc đó gói gọn trong một dòng: cùng chuyên mục, và tiêu đề có chữ trùng nhau.
Trên một trang chuyên về AI thì gần như bài nào cũng có chữ “AI” trong tiêu đề. Thế là một bài về AI trong quân sự được gắn link sang một bài về khoá học AI miễn phí. Hai bài chẳng liên quan gì, ngoài hai chữ cái. Tệ hơn, đám link ấy không nằm trong mạch câu chữ mà bị nhét thành một khối “Đọc thêm” ở cuối bài — thứ mà mọi bài đều có, giống hệt nhau, đúng định nghĩa của khuôn mẫu vô nghĩa.
Điểm đáng sợ không phải là link xấu. Là 412 bài cùng xấu một kiểu. Một quy tắc tự động sai thì không sai lẻ tẻ vài bài để mình kịp nhận ra — nó sai đều, sạch sẽ, trên toàn bộ tập dữ liệu, trong vòng vài phút. Tôi phải viết một công cụ khác để gỡ sạch, và cái công cụ gỡ ấy tốn nhiều thời gian hơn cái công cụ gắn.
Suýt sai lần thứ ba: 188 link, 98% cùng một chữ neo
Sửa xong, tôi nghĩ ra một ý nghe rất hợp lý: dồn link về 5 trang quan trọng nhất — những trang giải nghĩa mà tôi muốn xếp hạng. Chạy thử ở chế độ không ghi, công cụ báo tìm được 188 link có thể gắn. Con số đẹp.
Rồi tôi xem danh sách thay vì xem con số. 98% trong đó là chữ “SEO” trỏ về trang “SEO là gì” — một chữ neo duy nhất, lặp 184 lần trên toàn site. Bốn trang còn lại thì gần như đã được link đủ từ trước.
Một chữ neo lặp gần 200 lần không phải là mạng lưới nội dung. Đó là dấu vết máy móc, và là kiểu tối ưu quá tay mà chính Google khuyên tránh. Tôi bỏ toàn bộ, viết lại danh sách chỉ gồm 29 thực thể cụ thể — GPT-5, Codex, Claude Code, Firecrawl… — và bỏ hết những từ chung như SEO, backlink, tương tác. Lần chạy mới ra 59 link ở 50 bài, chữ neo đa dạng. Ít hơn ba lần, nhưng mỗi link nói được một điều cụ thể.
Lần này tôi bắt được trước khi ghi, chỉ vì một thói quen rẻ tiền: chạy thử ở chế độ không ghi, rồi đọc danh sách chứ đừng đọc con số tổng.
Cách cuối cùng chạy được
Cách làm cuối cùng có ba lớp, và điểm chung là không lớp nào tin lớp trước:
- Đề xuất. Chia bài thành từng lô 25 bài, mỗi lô một tác nhân AI đọc và đề xuất link nào nên gắn, chữ neo là cụm nào.
- Phản biện đối kháng. Một lượt tác nhân khác đọc lại từng đề xuất với đúng một nhiệm vụ: tìm lý do bác bỏ. Vòng này loại 90 link.
- Công cụ tự kiểm. 348 đề xuất còn sống mới đi vào công cụ ghi. Nó kiểm lại từng cái: chữ neo có nằm nguyên văn trong một đoạn văn không, chỗ đó đã nằm trong thẻ liên kết khác chưa, bài này đã có link tới đích chưa, đúng ngôn ngữ chưa, đã đủ 3 link chưa, có đụng vào tiêu đề hay mục nguồn tham khảo không.
Kết quả cuối: 164 link vào 143 bài. 184 đề xuất bị loại ở lớp thứ ba, gần hết vì bài đó đã có sẵn link tới đúng trang ấy rồi. Nói cách khác, một nửa số việc mà hai lớp AI cho là cần làm thì thực tế không cần làm — và chỉ lớp kiểm bằng mã, không phải lớp AI, mới phát hiện được điều đó.
Luật chốt lại cũng gọn: link đi từ bài tin và bài hướng dẫn về trang giải nghĩa, không link tin sang tin; chữ neo phải là cụm từ có sẵn trong câu, không phải tiêu đề bài đích; tối đa 3 link mỗi bài; chỉ gắn khi bài thật sự bàn về thứ đó, không phải nhắc lướt một lần.
Đo lại sau một tháng, và chỗ tôi quên
Hôm nay 14/08, tôi chạy lại vài câu đếm trên cơ sở dữ liệu để xem việc dọn có giữ được không. Trong 1.633 bài đang đăng: 192 bài có link tới trang “OpenAI là gì”, 129 bài tới “AI Agent là gì”. Khối “Bài viết liên quan” nhét trong thân bài — thứ trùng với khối mà giao diện vốn đã tự dựng — nay còn 0 bài. Phần dọn giữ nguyên.
Nhưng cùng câu đếm ấy lôi ra một chỗ tôi quên. Khối tương tự ở phiên bản tiếng Anh, mang tiêu đề “Related articles”, vẫn còn trong 57 bài — tất cả đều là bài tiếng Anh. Hồi tháng 7 tôi viết công cụ dọn theo đúng chuỗi tiếng Việt, chạy xong thấy về 0 rồi đóng việc, không nghĩ tới chuyện site có hai ngôn ngữ.
Còn một chỗ nữa cùng họ: 491 bài kết thúc bằng đúng một câu “Đọc thêm các bài cùng chuyên mục…”. Câu này ít hại hơn — nó trỏ về chuyên mục, không trỏ bừa sang bài lạc đề — nhưng vẫn là một dòng giống hệt nhau ở gần một phần ba số bài. Tôi ghi lại con số ở đây chứ chưa gỡ, vì gỡ hàng loạt là chuyện phải bàn trước rồi mới làm; tôi vừa học bài học ấy đúng một tháng trước.
Bốn thứ tôi mang đi khỏi vụ này
Đo ở nơi Google đọc, đừng đo ở nơi mình lưu. Nội dung trong cơ sở dữ liệu và trang HTML cuối cùng là hai thứ khác nhau. Mọi con số về link, về ảnh, về chữ, nếu lấy từ nơi lưu thì phải kiểm lại trên trang render trước khi mở miệng.
Chạy thử rồi đọc danh sách, đừng đọc con số tổng. “188 link” nghe như thành công. Mở danh sách ra mới thấy nó là một chữ lặp 184 lần. Con số tổng giấu được gần như mọi thứ.
Quy tắc tự động sai thì sai đều. Sửa tay hỏng một bài, sửa tự động hỏng bốn trăm bài trong hai phút. Nên với việc hàng loạt, giá của một vòng kiểm trước khi ghi luôn rẻ hơn giá của việc gỡ sau đó.
AI đề xuất thì tốt, nhưng phải có lớp kiểm bằng mã. Hai lớp tác nhân đọc nội dung rất giỏi, vẫn đề xuất 184 việc không cần làm. Cái bắt được là một đoạn mã ngắn ngủi đi hỏi cơ sở dữ liệu “bài này đã có link đó chưa”. Việc kiểm sự thật thì nên giao cho thứ không biết tưởng tượng.
Và một ghi chú cho chính tôi: mỗi lần dọn dẹp trên một site đa ngôn ngữ, đếm lại ở cả hai ngôn ngữ rồi hẵng đóng việc. Nếu tháng 7 tôi làm thế thì hôm nay đã không phải viết ra con số 57.