Nội dung
- Cuộc đua model AI chuyển sang khả năng làm việc trong hệ thống
- Kết nối ad account và checkpoint đang đổi việc marketer phải kiểm
- Chi phí kiểm tra mới là phần đo lường bị bỏ quên của model AI
- Các tuyên bố chưa xác nhận về năng lực model cần được tách khỏi kế hoạch mua
- Bài toán agentic model ở Việt Nam nằm ở tiếng Việt và quyền thao tác
- Giao việc cho model AI sau khi chốt bộ test và điểm dừng
- Nguồn tham khảo
Model AI đang được cạnh tranh bằng khả năng làm việc trong hệ thống thật, không chỉ bằng điểm benchmark hay câu trả lời đẹp. Với marketer Việt Nam, thay đổi quan trọng nhất là cách đo hiệu quả: phải nhìn vào việc đã hoàn tất, số lỗi cần sửa và thời gian con người phải giám sát.
Điểm chính
- Agentic model chuyển trọng tâm từ sinh câu trả lời sang thực hiện chuỗi việc có kiểm soát.
- Lượt tải, benchmark và tốc độ phản hồi không đủ để kết luận một model tạo ra giá trị marketing.
- Chi phí kiểm tra và quyền cho máy tự thao tác có thể lớn hơn tiền trả cho API.
- Đội marketing Việt Nam cần bộ test bằng tiếng Việt, giới hạn hành động và người duyệt trước khi mở rộng.
Cuộc đua model AI chuyển sang khả năng làm việc trong hệ thống
Các diễn biến trong nguồn cho thấy một hướng đi chung: model được thiết kế để làm việc với công cụ, dữ liệu và các bước kiểm tra cụ thể. Grok 4.7 được giới thiệu như model phục vụ công việc tri thức trong Grok Bot, còn MiMo-V2.6 nhấn mạnh việc mở rộng RL cho code và các tác vụ agent. Hai cách tiếp cận này đều đặt đầu ra thực tế lên trước việc chỉ tạo một câu trả lời.
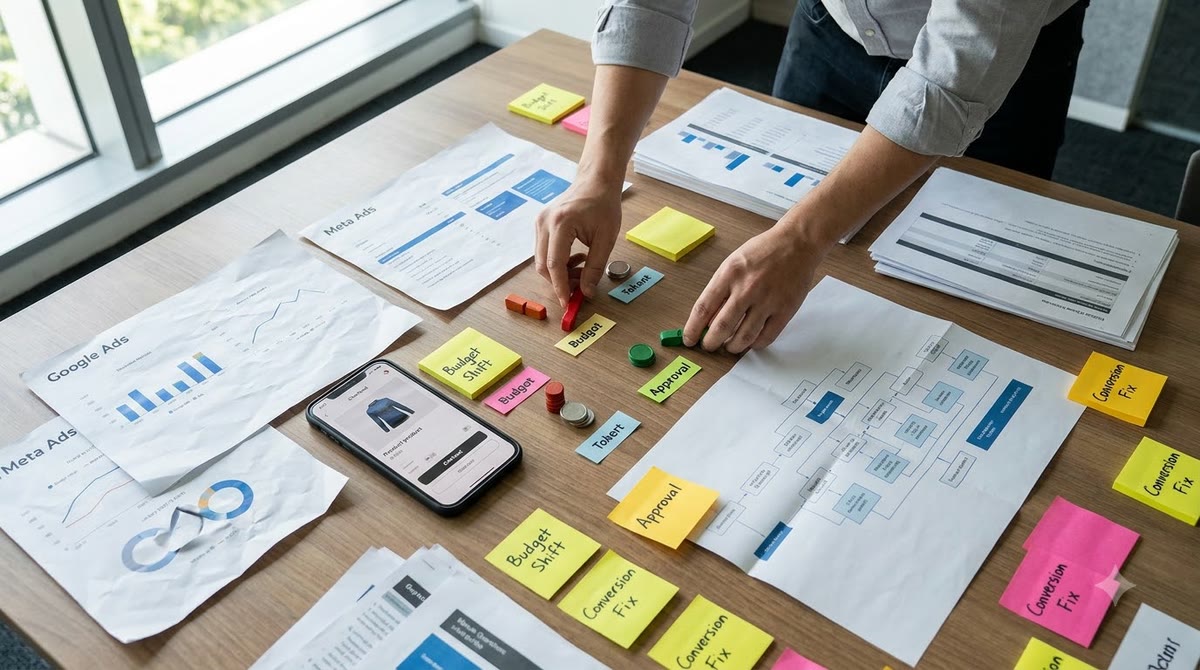
Ở phía ứng dụng, Muse kết nối với Google Ads, Meta Ads, các nền tảng quảng cáo, GSC, GA4, Semrush, Ahrefs, Shopify, WordPress và nhiều công cụ khác. Helix lại chia công việc thành checkpoint, đặt quality gate và dùng phản hồi của kỹ sư để cải thiện các lần chạy sau. Vì vậy, model AI đang tiến gần hơn tới một nhân sự vận hành có thể nhận việc, thực hiện, tự kiểm và xin duyệt ở điểm cần thiết.
Kết nối ad account và checkpoint đang đổi việc marketer phải kiểm
Khối cập nhật dưới đây chỉ gồm những khả năng được mô tả trực tiếp trong các nguồn. Điểm cần chú ý không phải tên sản phẩm, mà là loại công việc marketing có thể được giao cho máy.
Kết nối ad account: chuyển từ đọc dashboard sang xử lý việc
Muse có thể truy cập tài khoản quảng cáo, công cụ SEO, nền tảng bán hàng và website. Mô tả của Ira Bodnar cho biết công cụ có thể trả lời câu hỏi về quảng cáo, SEO và Shopify, thực hiện thay đổi, theo dõi vấn đề liên tục và chủ động đề xuất thay đổi để cải thiện ROAS. Điều đó chạm trực tiếp vào việc phân tích, chỉnh ngân sách, sửa trang và theo dõi chuyển đổi. Marketer cần xác định hành động nào được phép chạy tự động, hành động nào bắt buộc có người duyệt.
Checkpoint của Helix: biến kiểm tra chất lượng thành một phần của workflow
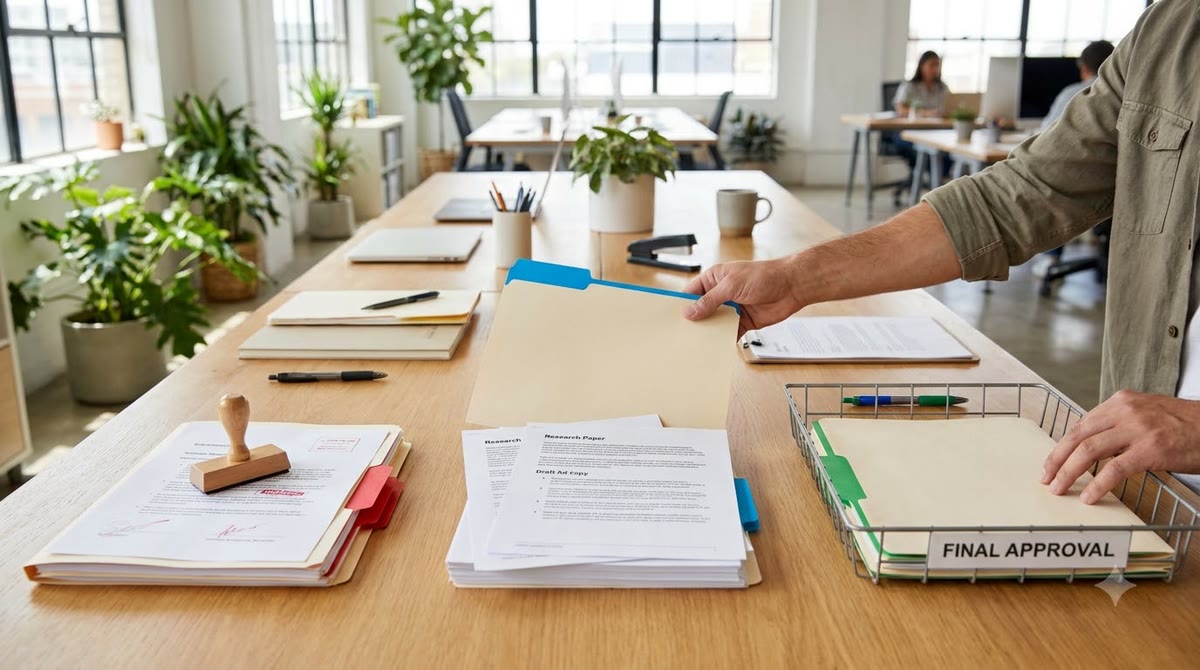
Helix chia công việc thành các checkpoint nhỏ. Mỗi checkpoint phải qua quality gate trước khi chuyển tiếp; phản hồi của kỹ sư được lưu để các lần sau tự chủ hơn. Mô tả trong bài đăng về Helix cũng nêu khả năng chạy qua đêm mà vẫn giữ cổng kiểm tra. Với đội marketing, điều này có nghĩa là không nên giao một yêu cầu lớn rồi chờ bản cuối. Hãy chia việc thành nghiên cứu, tạo bản nháp, kiểm tra dữ liệu, chỉnh sửa và phê duyệt.
Chi phí kiểm tra mới là phần đo lường bị bỏ quên của model AI
Lượt tải không thay thế tỷ lệ hoàn tất công việc
Polymarket Money cho biết Muse có số lượt tải sau khi ra mắt cao hơn ChatGPT, Grok và Claude trong một so sánh được đăng trên X. Đây là tín hiệu về mức chú ý và khả năng tiếp cận, nhưng không cho biết người dùng hoàn tất bao nhiêu chiến dịch, sửa bao nhiêu lỗi hay tạo ra bao nhiêu doanh thu. Ngược lại, mô tả về Grok 4.7 của Alex Finn tập trung vào workflow cho công việc tri thức. Hai ví dụ này cho thấy lượt tải và khả năng hoàn tất là hai chuẩn đo khác nhau.
Trong marketing, dashboard nên bổ sung các chỉ số như tỷ lệ task hoàn tất không cần làm lại, số lần người duyệt can thiệp, thời gian từ yêu cầu đến đầu ra dùng được và chi phí cho mỗi task đạt chuẩn. CTR hay ROAS vẫn cần giữ, nhưng chúng phải được nối với chất lượng đầu vào và cách agent tạo ra thay đổi.
RL và quality gate: chi phí suy luận đi cùng chi phí giám sát
Fuli Luo mô tả MiMo-V2.6 là một dự án dùng lượng compute lớn cho RL, trong đó các tác vụ code và agent có thể kiểm chứng được xử lý riêng với các tác vụ khó kiểm tra hơn. Helix lại dùng các cổng chất lượng nhỏ và phản hồi của kỹ sư để kiểm soát từng bước. Hai nguồn này chỉ ra cùng một cơ chế: để model làm việc dài hơn, doanh nghiệp phải trả cho cả năng lực suy luận lẫn hệ thống kiểm tra.
Vì thế, so sánh giá API giữa các model có thể gây lệch quyết định. Một model rẻ nhưng thường xuyên tạo bản sai sẽ kéo theo giờ kiểm tra, chi phí sửa và rủi ro chạy nhầm trên tài khoản quảng cáo. Báo cáo hiệu quả nên tách tiền dùng model, thời gian người duyệt và tổn thất do hành động sai.
Các tuyên bố chưa xác nhận về năng lực model cần được tách khỏi kế hoạch mua
Có nên lấy tuyên bố giải được bài toán khó làm chuẩn chọn model?
Một bài đăng của kimmonismus kể rằng một model của OpenAI giải được 100 bài toán mở lâu năm, đồng thời nhận xét ban đầu về Grok 4.7 và MiMo-V2.6 đã bị đánh giá lại. Đây là lời kể trên mạng xã hội, không phải tài liệu kỹ thuật đầy đủ hay xác nhận độc lập từ OpenAI; chính người đăng cũng thừa nhận đã kết luận quá sớm. Tương tự, nhận định MiMo-V2.6 là model mã nguồn mở số một trong nguồn của Fuli Luo là quan điểm của người tham gia dự án, không phải chuẩn đo độc lập cho mọi nhu cầu marketing.
Điều dùng được: đội marketing không cần bỏ qua các tín hiệu này, nhưng phải đưa chúng vào danh sách cần kiểm tra. Hãy yêu cầu model chạy trên bộ prompt, dữ liệu và workflow thật của doanh nghiệp; lưu đầu ra, lỗi, thời gian sửa và mức tiêu thụ tài nguyên trước khi đổi hợp đồng hoặc tăng ngân sách.
Bài toán agentic model ở Việt Nam nằm ở tiếng Việt và quyền thao tác
Marketer Việt Nam thường phải xử lý tiếng Việt có dấu, tên riêng, địa chỉ, đơn vị tiền, cách gọi sản phẩm địa phương và dữ liệu khách hàng pha trộn nhiều định dạng. Một model có kết quả tốt trong code hoặc toán chưa chắc làm tốt việc phân loại bình luận, viết quảng cáo theo giọng thương hiệu hay đọc báo cáo bán hàng tiếng Việt. Vì vậy, bộ test cần dùng dữ liệu đã ẩn thông tin cá nhân và có tiêu chí chấm cụ thể.
Quyền truy cập cũng cần được giới hạn theo hành động. Agent có thể được phép đọc GA4 và đề xuất thay đổi, nhưng chưa được tự tăng ngân sách, sửa giá sản phẩm hoặc xuất bản nội dung. Khi kết nối nhiều công cụ như Muse mô tả, một lỗi nhỏ ở truy vấn hoặc mapping dữ liệu có thể lan sang quảng cáo, website và cửa hàng. Checkpoint kiểu Helix là cách thiết thực để giữ người chịu trách nhiệm ở các điểm có rủi ro.
Giao việc cho model AI sau khi chốt bộ test và điểm dừng
- Chọn một workflow có đầu ra rõ, chẳng hạn kiểm tra landing page, phân loại truy vấn SEO hoặc phát hiện nhóm quảng cáo có dấu hiệu sai lệch.
- Đo bốn thứ trước khi mở rộng: tỷ lệ hoàn tất, số lần sửa, thời gian người duyệt và tổng tiền thực tế cho mỗi task đạt chuẩn.
- Đặt quality gate trước các hành động có thể tiêu tiền hoặc thay đổi dữ liệu; bắt buộc người duyệt ở bước tăng ngân sách, xuất bản và chỉnh giá.
- Chạy thử bằng dữ liệu tiếng Việt đã ẩn thông tin cá nhân, lưu log đầu vào và đầu ra, rồi mới cho agent kết nối thêm tài khoản marketing.
Xem thêm phân tích & hướng dẫn marketing tại https://marketing365.vn.
Theo dõi thêm các bài phân tích từ Marketing365 để cập nhật xu hướng marketing mới nhất.
Đọc thêm các bài cùng chuyên mục Động thái AI.
Nguồn tham khảo
- Grok 4.7 just released and it’s an EXCELLENT model — Alex Finn
- Meta’s Muse surpasses ChatGPT, Grok and Claude in post-launch downloads — Polymarket Money
- MiMo-V2.6: The Hard Road to Scaling Up RL — Fuli Luo
- OpenAI, MiMo and Grok model reactions — kimmonismus
- Introducing Muse for Marketing — Ira Bodnar
- How Helix works with checkpoints and quality gates — Mustafa Ali