Nội dung
- Qwen3.8 và benchmark AI: thị trường mô hình chuyển sang đo việc làm
- LiveTranslate và Money Agent: tính năng mô hình AI chạm vào kênh phục vụ
- Benchmark độc lập làm đổi cách chọn kênh phân phối AI
- Khách hàng Việt trước bài toán mô hình AI và chi phí sửa sai
- Bộ test mô hình AI cần hoàn tất trước khi tăng ngân sách
- Nguồn tham khảo
Mô hình AI mới đang được đưa vào nhiều điểm chạm hơn, từ trợ lý tài chính đến phiên dịch trực tiếp. Với marketer Việt Nam, thay đổi quan trọng không nằm ở việc có thêm một model để thử, mà ở chỗ tiêu chuẩn chọn công cụ đang chuyển từ tên model sang đầu ra có thể dùng trong workflow và kênh phân phối cụ thể.
Da7em Bench, Money Agent và Qwen3.8-LiveTranslate cùng chỉ về một hướng: AI chỉ tạo giá trị khi doanh nghiệp đo được chất lượng công việc, tốc độ phục vụ và phần sửa lỗi phải trả.
Điểm chính
- Benchmark dựa trên task thật giúp marketing đánh giá model theo việc cần hoàn thành, không chỉ theo điểm số chung.
- Trợ lý tài chính và phiên dịch thời gian thực mở thêm điểm chạm, nhưng cũng đưa độ chính xác, độ trễ và khả năng xử lý ngữ cảnh vào bài toán phân phối.
- Ngân sách AI nên gắn với mức chấp nhận đầu ra, thời gian kiểm tra và chi phí sửa sai.
- Đội ngũ Việt Nam cần kiểm thử riêng tiếng Việt, thuật ngữ ngành và quy trình người duyệt trước khi mở rộng.
Qwen3.8 và benchmark AI: thị trường mô hình chuyển sang đo việc làm
Các nguồn được sử dụng trong bài cho thấy mô hình AI đang rời khỏi cách đánh giá chỉ dựa trên khả năng trả lời. Da7em Bench mô tả một bộ benchmark độc lập, dùng khoảng 200 task thực tế trong mỗi 12 nhóm như research, planning, accuracy, honesty, engineering, writing và communication. Điểm cao nhất chỉ có ý nghĩa khi sản phẩm được chấp nhận như đầu ra của một người làm nghề, thay vì chỉ đúng trên một bài test. Nguồn Da7em và mô tả Money Agent cho thấy cùng một câu hỏi tài chính có thể đi từ hội thoại đến mục tiêu cụ thể khi model được đặt trong một công cụ có nhiệm vụ rõ ràng. Nguồn Qwen và Cerebras
Điều này đặt lại vai trò của marketer. Người mua không còn chỉ hỏi model nào thông minh hơn. Họ phải hỏi model nào hoàn thành tốt phần việc của mình, trong kênh nào, với bao nhiêu lần người thật cần sửa.
LiveTranslate và Money Agent: tính năng mô hình AI chạm vào kênh phục vụ
Khối cập nhật dưới đây chỉ giữ những khả năng được mô tả cụ thể trong nguồn. Mỗi khả năng đều có liên hệ trực tiếp với cách đội marketing thiết kế trải nghiệm và chọn điểm chạm.
Money Agent: biến câu hỏi mua nhà thành quy trình tư vấn có mục tiêu
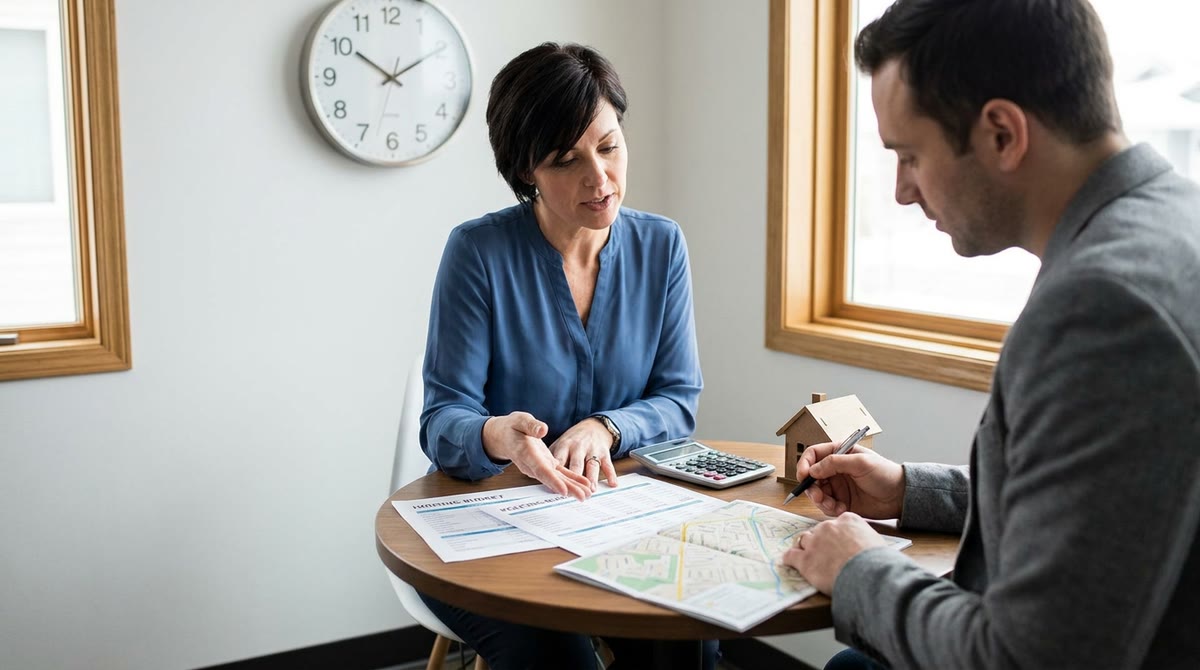
Money Agent là trợ lý tài chính cá nhân dùng Qwen 3.8 27B trên hạ tầng Cerebras. Công cụ nhận một câu hỏi về mua nhà, duy trì hội thoại theo thời gian thực rồi chuyển thành mục tiêu tài chính. Với marketing trong lĩnh vực tài chính, đây không chỉ là hộp chat trả lời FAQ. Đội ngũ cần thiết kế prompt, nội dung giải thích và bước chuyển sang tư vấn viên sao cho người dùng hiểu được mục tiêu tiếp theo. Nguồn Qwen và Cerebras
Qwen3.8-LiveTranslate: đưa độ trễ và nhận diện người nói vào trải nghiệm đa ngôn ngữ
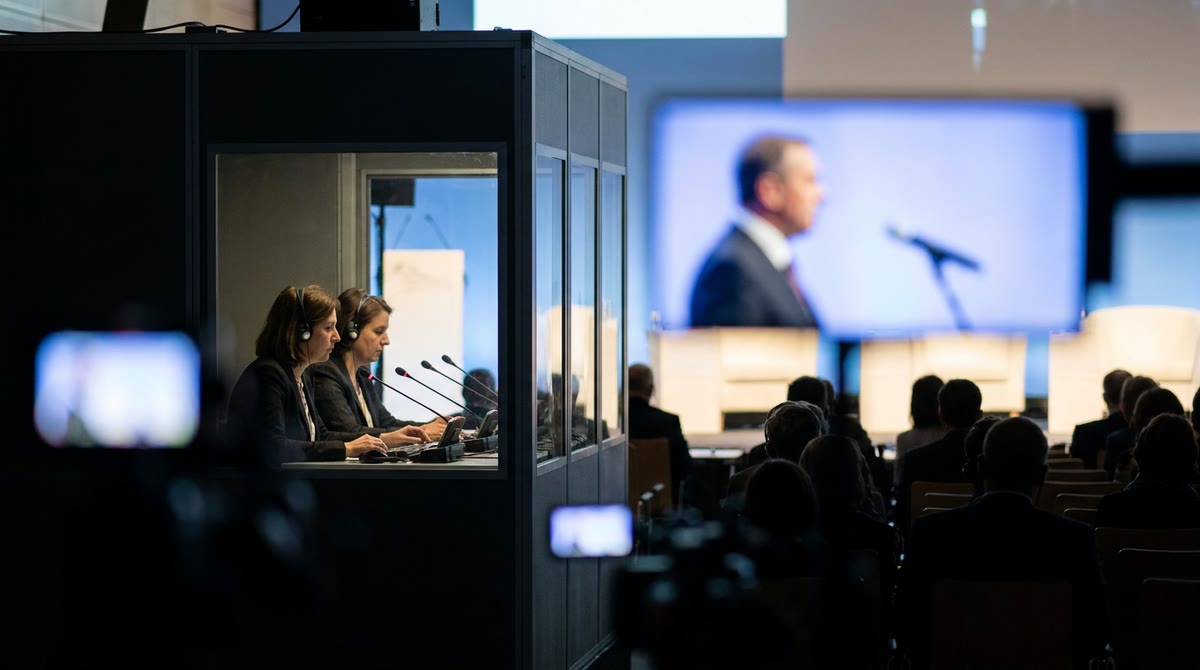
Qwen3.8-LiveTranslate là model phiên dịch đồng thời cho 60 ngôn ngữ. Nguồn Qwen nêu độ trễ trung bình LAAL giảm từ 2,8 giây xuống 2,3 giây, cùng các khả năng nhận diện người nói, hiển thị song ngữ đồng bộ và dùng lịch sử hội thoại để làm rõ tên riêng, thuật ngữ. Đội marketing tổ chức sự kiện, tư vấn quốc tế hoặc hỗ trợ khách hàng cần tính cả thời gian chờ, cách hiển thị bản gốc và bản dịch, cũng như khả năng giữ đúng giọng của từng người. Nguồn Qwen LiveTranslate
Benchmark độc lập làm đổi cách chọn kênh phân phối AI
Chuẩn chấp nhận đầu ra thay bảng xếp hạng bằng quyết định mua
Da7em Bench chấm theo thang 1–5, trong đó 5 nghĩa là công việc được chấp nhận như đã giao, điểm giữa là cần sửa và 1 là thất bại. Cách chấm này có ý nghĩa marketing vì nó nối model với kết quả cuối cùng: một bài viết được duyệt, một kế hoạch nghiên cứu dùng được hoặc một đoạn trao đổi khách hàng không cần viết lại toàn bộ. Money Agent bổ sung ví dụ về việc đặt model trong quy trình phục vụ, nơi giá trị không nằm ở câu trả lời riêng lẻ mà ở khả năng đưa người dùng tới một mục tiêu tài chính. Da7em Bench và Money Agent cùng cho thấy đầu ra cần được đánh giá trong bối cảnh sử dụng.
Vì vậy, dashboard của đội marketing nên có cột “được duyệt”, “cần sửa” và “không dùng được”, thay vì chỉ ghi điểm benchmark tổng. Đây là dữ liệu giúp quyết định model nào phù hợp với từng workflow.
Độ trễ và ngữ cảnh kéo chi phí tiếp cận vào thiết kế kênh
Phiên dịch trực tiếp với LAAL 2,3 giây không tạo ra cùng trải nghiệm như một công cụ trả lời sau vài phút. Tương tự, Money Agent được mô tả như một cuộc hội thoại thời gian thực chuyển sang mục tiêu tài chính. Hai ví dụ này cho thấy kênh AI có chi phí không chỉ ở API hay hạ tầng. Doanh nghiệp còn phải trả cho việc thiết kế hội thoại, chuẩn bị dữ liệu, giám sát câu trả lời và xử lý trường hợp người dùng bỏ cuộc vì chờ lâu. Qwen LiveTranslate và Money Agent
Trong kế hoạch phân phối, tốc độ cần được gắn với hành vi cụ thể. Một phiên tư vấn mua nhà có thể cần hội thoại dài và chuyển mục tiêu. Một sự kiện đa ngôn ngữ lại cần phản hồi nhanh và hiển thị rõ. Dùng cùng một tiêu chuẩn cho hai kênh sẽ làm sai bài toán ngân sách.
Harness và task riêng làm lộ phần kiểm chứng trước khi mở rộng
Da7em Bench cho biết mỗi model được thử trên nhiều harness như Droid, Hermes Agent, Devin và Cursor, thay vì để một môi trường duy nhất quyết định kết quả. Các task được giữ riêng để tránh bị đưa vào dữ liệu huấn luyện và làm điểm số tương lai thiếu tin cậy. Khi đặt cạnh LiveTranslate, nơi model phải xử lý người nói, ngữ cảnh dài và nhiều ngôn ngữ, ta thấy một model có thể cần nhiều lớp kiểm tra trước khi được đưa vào kênh có khách hàng thật. Da7em Bench và Qwen LiveTranslate
Chi phí kiểm chứng vì thế không phải bước phụ sau khi chọn model. Nó là một phần của chi phí phân phối. Càng nhiều ngôn ngữ, người nói và tình huống ngoại lệ, bộ test càng phải gần với dữ liệu vận hành.
Khách hàng Việt trước bài toán mô hình AI và chi phí sửa sai
Doanh nghiệp Việt có thể hưởng lợi từ các model hỗ trợ hội thoại, nghiên cứu và dịch thuật, nhưng không nên lấy thông số công bố làm bằng chứng đủ để triển khai. Tiếng Việt có tên riêng, tiếng lóng, cách viết tắt và thuật ngữ ngành. Những yếu tố này ảnh hưởng trực tiếp đến nội dung quảng cáo, tư vấn và chăm sóc khách hàng.
Với Money Agent, đội tài chính cần kiểm tra cách model hiểu số tiền, mục tiêu và điều kiện vay theo cách người Việt diễn đạt. Với LiveTranslate, doanh nghiệp cần thử tên thương hiệu, địa danh, thuật ngữ sản phẩm và hội thoại nhiều người. Với benchmark, cần tạo task nội bộ bằng brief thật, rồi chấm theo tỷ lệ được duyệt và số phút sửa. Cách làm này giúp ngân sách phản ánh tổng tiền thực tế phải bỏ ra, không chỉ giá dùng model.
Bộ test mô hình AI cần hoàn tất trước khi tăng ngân sách
- Chọn một workflow có đầu ra rõ, chẳng hạn viết brief, tư vấn ban đầu hoặc dịch nội dung sự kiện; ghi trước tiêu chuẩn “được duyệt”.
- Chạy cùng task trên nhiều model và nhiều harness; lưu số lần sửa, thời gian kiểm tra và lỗi ảnh hưởng đến khách hàng.
- Kiểm thử riêng tiếng Việt, tên riêng, thuật ngữ ngành và tình huống có nhiều người nói trước khi mở kênh công khai.
- Chỉ tăng ngân sách khi đầu ra đạt mức chấp nhận đã đặt, độ trễ phù hợp với hành vi khách hàng và đội ngũ biết ai chịu trách nhiệm duyệt.
Xem thêm phân tích & hướng dẫn marketing tại https://marketing365.vn.
Theo dõi thêm các bài phân tích từ Marketing365 để cập nhật xu hướng marketing mới nhất.
Đọc thêm các bài cùng chuyên mục Động thái AI.
Nguồn tham khảo
- Introducing Da7em Bench. An independent benchmark for AI models, built on real client work
- A great example of practical AI solving real-world problems! Money Agent powered by Qwen 3.8 27B on Cerebras
- Meet Qwen3.8-LiveTranslate, Qwen’s next-generation real-time simultaneous interpretation model