
Nội dung
- Model AI mới bước vào cuộc đua của đầu ra có thể kiểm tra
- Token và RAG trong model AI mới — chạm tới việc gì?
- Tốc độ, cấu trúc giao việc và citation đổi cách định giá model AI
- Những tuyên bố chưa xác nhận về DeepSeek V4.1 Flash và GrokBot
- Tiếng Việt và dữ liệu nội bộ đặt giới hạn cho model AI mới
- Chạy thử model AI mới trên workflow thật trước khi tăng ngân sách
- Nguồn tham khảo
Model AI mới không chỉ tạo thêm lựa chọn công cụ cho marketer. Nó đang kéo quyết định mua về gần công việc thực tế hơn: tốc độ xử lý, tổng tiền phải trả, khả năng nối dữ liệu và mức độ kiểm chứng của đầu ra. Với đội marketing Việt Nam, thay đổi này quan trọng vì ngân sách AI dễ bị chia nhỏ cho nhiều công cụ nhưng thiếu một cách đo thống nhất.
Điểm chính
- Giá trị của model được quyết định bởi đầu ra trong workflow, không phải tên model.
- Tốc độ và chi phí theo token cần được đo cùng chất lượng và thời gian kiểm tra.
- Agent chỉ tạo năng suất khi được giao việc theo cấu trúc và có điểm kiểm soát.
- Marketer Việt nên thử trên dữ liệu thật, có log, citation và tiêu chí dừng rõ ràng.
Model AI mới bước vào cuộc đua của đầu ra có thể kiểm tra
Sáu diễn biến trong dữ liệu nguồn cùng cho thấy một thay đổi: model không còn được đánh giá riêng như một sản phẩm trò chuyện. DeepSeek V4.1 Flash được mô tả qua tốc độ 230–300 TPS và lượng token phục vụ trong Command Code; AMD lại bị đặt cạnh Nvidia qua hiệu suất trên mỗi đô la khi hỗ trợ model chậm hơn. Ở phía ứng dụng, Azure RAG được mô tả như một chuỗi từ lấy dữ liệu, tìm kiếm, lọc quyền truy cập đến trả lời có citation. Xem thêm các mô tả trong bài đăng về DeepSeek V4.1 Flash, phân tích CUDA và AMD và quy trình RAG trên Azure.
Điểm chung là người dùng phải trả giá cho cả phần model chạy bên trong và phần vận hành xung quanh nó. Một model nhanh nhưng khó kiểm chứng có thể làm tăng giờ biên tập. Một agent có nhiều khả năng nhưng được dùng trong một cửa sổ chat duy nhất có thể không tạo ra năng suất như kỳ vọng. Vì vậy, luận điểm phù hợp với marketer là: hãy mua khả năng hoàn tất công việc, không chỉ mua quyền truy cập vào model.
Token và RAG trong model AI mới — chạm tới việc gì?
Khối cập nhật dưới đây chỉ ghi nhận những công cụ, khả năng hoặc con số được nêu trực tiếp trong tư liệu. Chúng là đầu vào để đội marketing thiết kế phép thử, không phải bằng chứng rằng mọi tuyên bố đã được kiểm chứng độc lập.
DeepSeek V4.1 Flash: so sánh tốc độ với chi phí theo workflow
DeepSeek V4.1 Flash được một bài đăng mô tả là đạt 230–300 TPS và Command Code đã phục vụ 3,1 nghìn tỷ paid tokens trong 24 giờ đầu. Với marketing, thông tin hữu ích nằm ở cách đo: lấy cùng một tác vụ tạo nội dung, phân loại dữ liệu hoặc viết code, rồi ghi lại thời gian phản hồi, số token và thời gian con người phải sửa. Nguồn: Ahmad Awais.
CUDA và vLLM: kiểm tra phần cứng trước khi chuyển model
Phân tích của SemiAnalysis cho biết hỗ trợ DeepSeek V4.1 Flash trên CUDA xuất hiện sớm hơn hình ảnh tương ứng của AMD, đồng thời nêu chênh lệch hiệu suất trên mỗi đô la giữa các phần cứng. Đội marketing không cần tự biến thành đội hạ tầng, nhưng cần hỏi nhà cung cấp model chạy trên phần cứng nào, tốc độ thực tế ra sao và chi phí tăng thế nào khi lượng truy vấn tăng. Nguồn: SemiAnalysis.
Azure RAG: đưa citation và quyền truy cập vào yêu cầu đầu ra
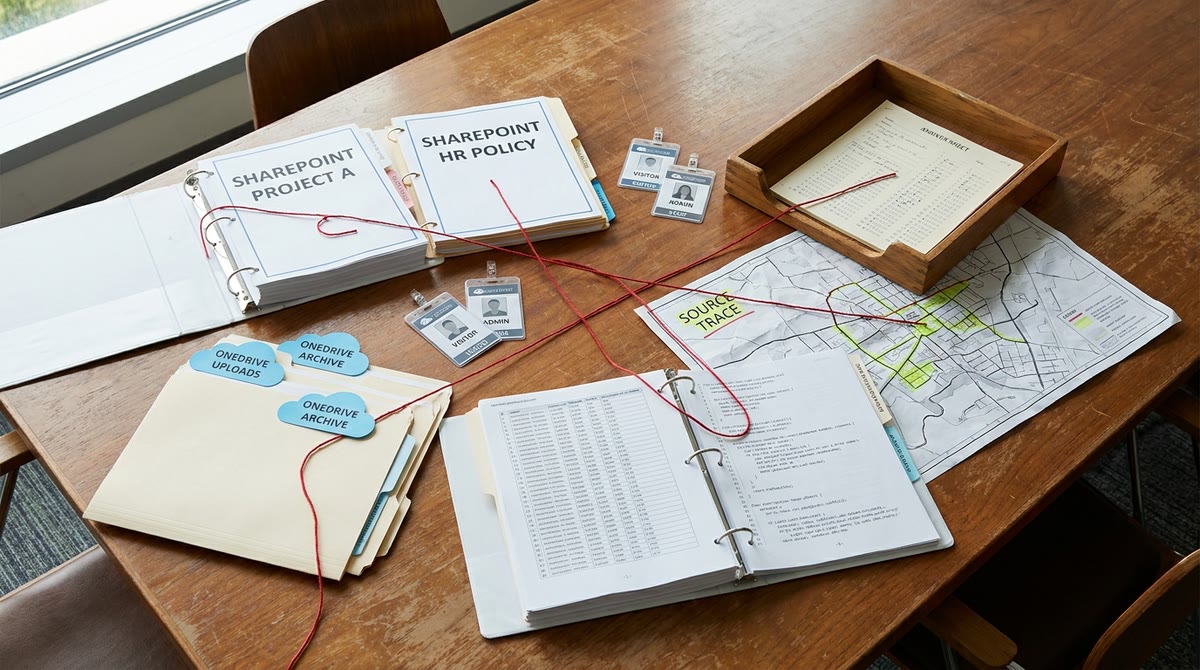
Quy trình Azure RAG kết hợp dữ liệu từ SharePoint, OneDrive, Blob Storage, SQL và các ứng dụng doanh nghiệp; sau đó tìm kiếm, lọc quyền, xếp hạng lại và tạo câu trả lời có nguồn. Điều này chạm trực tiếp tới content marketing, chăm sóc khách hàng và nghiên cứu thị trường: câu trả lời phải truy ra tài liệu nào, dùng dữ liệu ở thời điểm nào và ai được phép xem. Nguồn: Aiswarya Venkitesh.
Astra reset và context management: theo dõi chất lượng sau mỗi lần thay đổi
Một cập nhật của Astra nêu các vấn đề do skill cũ, thử nghiệm quản lý context và một số engine cấu hình kém; bài viết cũng nói nhóm đã tắt thử nghiệm ảnh hưởng khoảng 4–5 nghìn người dùng theo ước tính của họ. Với đội marketing, bài học kiểm được là phải có bộ prompt, mẫu đầu ra và dashboard so sánh trước–sau mỗi thay đổi, thay vì chỉ hỏi vài lần rồi kết luận. Nguồn: Codex Resets.
Tốc độ, cấu trúc giao việc và citation đổi cách định giá model AI
300 TPS không thay thế phép đo thời gian hoàn tất
Tốc độ được nêu trong bài về DeepSeek có ý nghĩa khi nó rút ngắn thời gian chờ trong một workflow cụ thể. Nhưng phân tích về CUDA cho thấy tốc độ còn phụ thuộc stack phần cứng và khả năng hỗ trợ model. Hai nguồn này cùng chỉ ra một cơ chế: marketer nên đo thời gian từ lúc giao việc đến lúc có bản được duyệt, không chỉ đo token mỗi giây. Nếu bản nhanh hơn vẫn cần nhiều vòng sửa, lợi ích thực tế có thể thấp hơn con số kỹ thuật.
Agent nhiều vai trò chỉ hiệu quả khi việc được chia thành chặng
Danh sách công cụ năm 2026 mô tả nhiều agent cho coding, xây app, lịch làm việc và tự động hóa tác vụ. Một lời kể khác mô tả cách tổ chức hơn 20 GrokBot agent theo Chief of Staff, manager và specialist, nhưng cũng nhận định phần lớn người dùng vẫn chỉ dùng một cửa sổ chat. Đặt cạnh quy trình RAG gồm các bước truy vấn, lọc, lấy dữ liệu và đánh giá, hai nguồn cho thấy agent cần đầu vào, vai trò và điểm bàn giao rõ ràng. Nếu không, việc tăng số agent chỉ làm tăng số chỗ phải kiểm tra. Nguồn: danh sách công cụ AI và mô tả cách dùng GrokBot.
Chất lượng model phải gắn với log và nguồn dẫn
Cập nhật Astra nhấn vào việc model theo dõi tin nhắn mới và kiểm tra công việc tốt hơn, còn Azure RAG đặt groundedness, relevance, latency và cost vào khâu đánh giá. Hai ví dụ này đưa ra cùng một yêu cầu cho marketing: lưu prompt, tài liệu đầu vào, câu trả lời, lỗi và thời gian xử lý. Khi đó, đội ngũ mới biết model kém ở khả năng hiểu brief, lấy sai dữ liệu hay chỉ gặp vấn đề ở bước cuối của workflow.
Những tuyên bố chưa xác nhận về DeepSeek V4.1 Flash và GrokBot
3,1 nghìn tỷ token có đủ để kết luận model thắng không?
Một tài khoản cá nhân gọi lượng 3,1 nghìn tỷ paid tokens là kỷ lục và đưa ra mức 230–300 TPS. Đây là tuyên bố từ bài đăng cá nhân; trong tư liệu không có xác nhận độc lập từ Command Code hay bảng so sánh đầy đủ. Điều dùng được: đội marketing có thể dùng các con số này làm giả thuyết để kiểm thử trên traffic, chi phí và chất lượng đầu ra của chính mình, không dùng làm căn cứ duy nhất để đổi nhà cung cấp.
Mô hình 20 agent có phải cách dùng chuẩn cho marketing?
Một bài đăng dẫn lời kỹ sư SpaceXAI nói chỉ khoảng 1% người dùng khai thác GrokBot theo cách tổ chức nhiều agent. Đây là lời kể qua tài khoản trung gian, chưa phải hướng dẫn được hãng xác nhận hoặc benchmark độc lập. Điều dùng được: hãy thử chia một workflow thành người lập kế hoạch, người kiểm tra và người thực thi ở quy mô nhỏ; nếu số vòng sửa không giảm, không cần mở rộng cấu trúc agent.
Tiếng Việt và dữ liệu nội bộ đặt giới hạn cho model AI mới
Ở Việt Nam, điểm khó không chỉ là chọn model có tốc độ cao. Brief thường trộn tiếng Việt, tên sản phẩm, bảng giá, quy định thương hiệu và dữ liệu khách hàng. Quy trình RAG cho thấy dữ liệu phải được lấy đúng, gắn metadata, lọc quyền và trả citation. Vì vậy, một model có điểm số tốt trên bài kiểm tra chung vẫn cần thử lại với FAQ tiếng Việt, nội dung ngành và các trường hợp khách hàng hỏi thiếu thông tin.
Đội marketing cũng nên tách ba nhóm việc: nội dung có thể tự động hóa, nội dung cần duyệt từng phần và dữ liệu không được đưa ra ngoài hệ thống. Cách chia này thực tế hơn việc giao toàn bộ quy trình cho một agent rồi sửa lỗi ở cuối.
Chạy thử model AI mới trên workflow thật trước khi tăng ngân sách
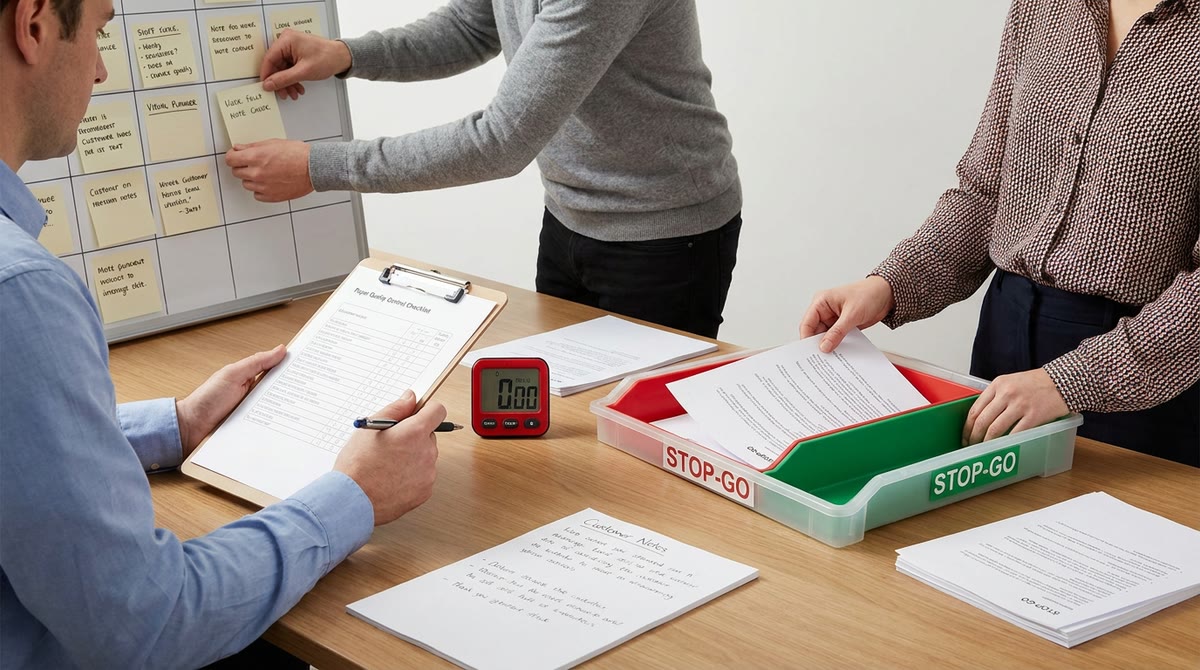
- Chọn một workflow có đầu ra rõ, chẳng hạn tạo bản nháp landing page hoặc trả lời FAQ, rồi ghi thời gian hoàn tất và số vòng sửa.
- So sánh ít nhất hai model bằng cùng prompt, cùng dữ liệu và cùng tiêu chí duyệt; ghi riêng token, chi phí và lỗi nội dung.
- Thêm citation, log và kiểm tra quyền truy cập trước khi nối model với dữ liệu khách hàng hoặc tài liệu nội bộ.
- Chỉ mở rộng agent sau khi chứng minh được số giờ tiết kiệm lớn hơn thời gian giám sát và sửa đầu ra.
Xem thêm phân tích & hướng dẫn marketing tại https://marketing365.vn.
Theo dõi thêm các bài phân tích từ Marketing365 để cập nhật xu hướng marketing mới nhất.
Đọc thêm các bài cùng chuyên mục Động thái AI.
Nguồn tham khảo
- Codex Resets — Astra reset and quality update
- SemiAnalysis — CUDA ecosystem and DeepSeek V4.1 Flash support
- Daniel Brooks — AI tools to know in 2026
- CyrilXBT — GrokBot multi-agent usage claim
- Ahmad Awais — DeepSeek V4.1 Flash first-24-hour usage claim
- Aiswarya Venkitesh — Enterprise RAG on Azure workflow
 Digital Trends
AI đang buộc marketing chuyển từ chạy theo tính năng sang kiểm soát rủi ro và giá trị thật
 Digital Trends
SEO bị ép minh bạch hơn: doanh nghiệp phải đo gì khi AI Search đổi cách ghi công?
 Digital Trends
