Nội dung
- Robotaxi và mô hình AI: cùng một bài toán kiểm chứng đầu ra
- Geofence Robotaxi: dữ liệu vận hành chạm tới cách chọn mô hình
- Đo đầu ra thay cho độ ồn của câu chuyện về mô hình AI
- Chưa xác nhận: quy mô Robotaxi và ý nghĩa của lần gọi Grok
- Tại thị trường Việt Nam, mô hình AI cần đi qua phạm vi thử nghiệm
- Đặt log và ngưỡng duyệt trước khi dùng mô hình AI
- Nguồn tham khảo
Mô hình AI mới thường được thị trường chú ý qua lời hứa, màn trình diễn và tên tuổi người đứng sau. Nhưng với marketer Việt Nam, giá trị dùng được phải nằm ở đầu ra có thể kiểm tra: máy làm được việc gì, trong phạm vi nào và kết quả có đủ ổn định để đưa vào quy trình hay không. Hai diễn biến quanh Robotaxi và lời gọi Grok trong các bài đăng nguồn cho thấy khoảng cách giữa câu chuyện và năng lực vận hành vẫn rất lớn.
Điểm chính
- Một màn ra mắt chỉ có giá trị marketing khi đi kèm phạm vi triển khai và dữ liệu vận hành.
- Geofence nhỏ và số lượng xe ít khiến chỉ số “đã triển khai” chưa đủ để kết luận về năng lực mô hình.
- Nhận xét về thiên lệch truyền thông hay “pump” cho cuộc gọi kết quả là ý kiến, không phải bằng chứng độc lập.
- Marketer Việt nên thử mô hình trên tác vụ hẹp, lưu log và đặt ngưỡng duyệt trước khi mở rộng ngân sách.
Robotaxi và mô hình AI: cùng một bài toán kiểm chứng đầu ra
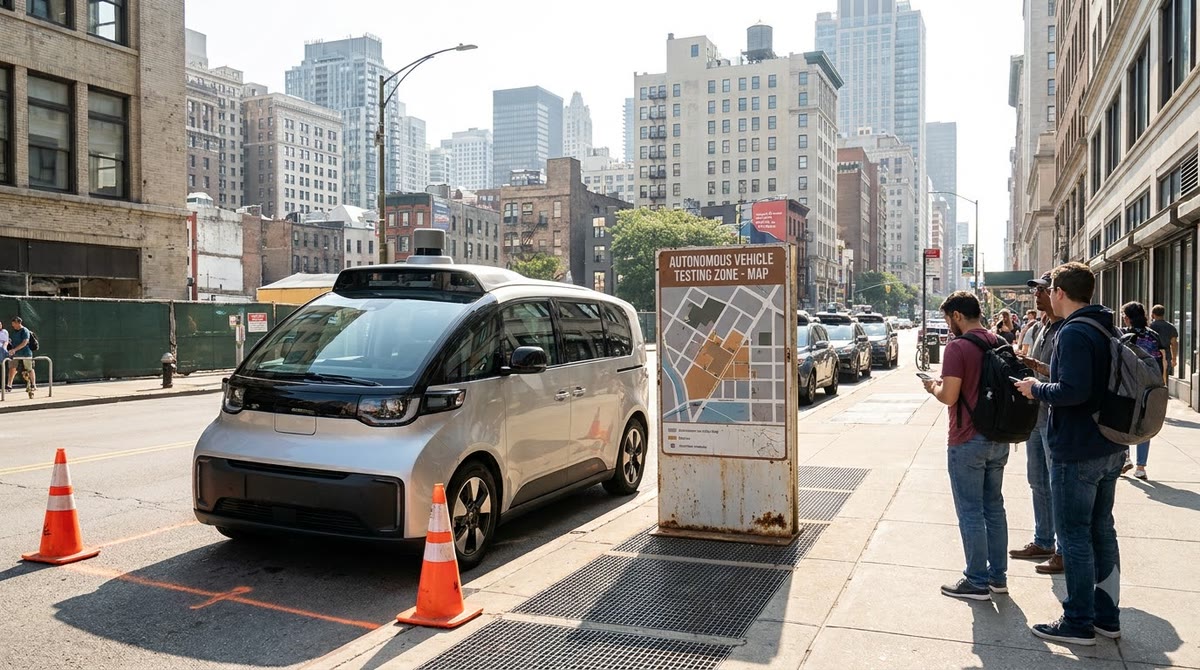
Hai nguồn không cung cấp thông số kỹ thuật mới của một model cụ thể. Thay vào đó, chúng cho thấy cách công chúng đánh giá năng lực AI qua bằng chứng bên ngoài. Bài đăng của Mike P đặt câu hỏi về việc Robotaxi ở Tampa và Orlando chỉ có khoảng 2–3 xe trong mỗi thành phố, nằm trong geofence nhỏ, rồi ít thay đổi sau sáu tuần. Bài đăng cũng nhắc tới việc người dùng cho rằng phạm vi ở Tampa chưa hữu ích cho việc đi lại trong khu trung tâm (nguồn Mike P).
Ở hướng khác, DogeDesigner trình bày một danh sách dài về thành tựu của Elon Musk để phản bác cách một teaser phim tài liệu mô tả nhân vật này (nguồn DogeDesigner). Hai bài đăng khác nhau về chủ đề, nhưng cùng chỉ ra một vấn đề: số lượng tuyên bố không thay thế được việc kiểm tra kết quả trong bối cảnh cụ thể.
Geofence Robotaxi: dữ liệu vận hành chạm tới cách chọn mô hình
Phần này chỉ ghi nhận những gì nguồn mô tả, không xem đó là công bố kỹ thuật chính thức. Dữ liệu về phạm vi hoạt động, số lượng phương tiện và khu vực phục vụ vẫn cần được đối chiếu với tài liệu từ doanh nghiệp trước khi dùng làm kết luận.
Phạm vi geofence: biến trải nghiệm AI thành bài toán đo được
Một hệ thống tự lái có thể hoạt động trong một khu vực giới hạn mà chưa chắc phục vụ được toàn bộ nhu cầu người dùng. Bài đăng của Mike P nêu con số 2–3 xe ở mỗi thành phố và geofence nhỏ; phần trích dẫn của BrettKrieger12 cho rằng vùng phủ ở Tampa chưa hữu ích. Đặt cạnh danh sách năng lực được DogeDesigner nêu về FSD, Robotaxi và các sản phẩm liên quan, sự khác biệt nằm ở chỗ: lời hứa nói về khả năng rộng, còn trải nghiệm thực tế cần trả lời câu hỏi hẹp là máy xử lý được bao nhiêu tình huống trong vùng nào. Với đội marketing, đây là lý do phải ghi rõ phạm vi thử nghiệm thay vì dùng cụm “đã triển khai” như một chỉ số hoàn chỉnh.
Đo đầu ra thay cho độ ồn của câu chuyện về mô hình AI
Độ phủ sử dụng: không thể thay thế tỷ lệ tác vụ hoàn tất
Một thương hiệu có thể kể nhiều về năng lực kỹ thuật, nhưng người mua vẫn cần biết hệ thống hoàn thành tác vụ nào và thất bại ở đâu. Danh sách của DogeDesigner nhấn vào quy mô sản phẩm, từ xe điện, trạm sạc tới FSD và Robotaxi. Bài đăng của Mike P lại kéo sự chú ý về số xe, geofence và mức hữu ích của vùng phục vụ. Hai cách nhìn này cho thấy chỉ số “có mặt trên thị trường” không đủ để đánh giá mô hình AI. Marketer nên thay bằng các chỉ số cụ thể hơn: tỷ lệ tác vụ hoàn tất, tỷ lệ phải chuyển cho người, thời gian xử lý và số tình huống nằm ngoài phạm vi.
Câu chuyện thương hiệu: không được đứng thay cho bằng chứng độc lập
DogeDesigner cho rằng teaser đã dựng Elon Musk theo hướng tiêu cực và đưa ra danh sách thành tựu để cân bằng cách kể đó. Mike P lại nghi ngờ việc công bố Robotaxi ngay trước cuộc gọi kết quả có thể tạo cảm giác thúc đẩy kỳ vọng, dù người viết cũng nói không muốn khẳng định đó là chủ ý. Khi đặt hai nguồn cạnh nhau, marketer thấy rõ một rủi ro đo lường: bên sở hữu thương hiệu và bên phản biện đều có thể chọn dữ kiện có lợi cho luận điểm của mình. Vì vậy, dashboard đánh giá AI nên tách tuyên bố thương hiệu khỏi log sử dụng, phản hồi khách hàng và mẫu kiểm thử lặp lại.
Chi phí kiểm chứng: khoản phải trả trước khi mở rộng ngân sách
Việc một hệ thống được phép hoạt động ở một khu vực chưa nói lên chi phí để kiểm tra toàn bộ trường hợp sử dụng. Nguồn về Tampa và Orlando cho thấy cần xem cả quy mô triển khai thực tế, còn nguồn về danh sách sản phẩm cho thấy một năng lực có thể được trình bày ở cấp rất rộng. Với mô hình AI, cùng một nguyên tắc áp dụng cho prompt, agent hoặc công cụ tạo nội dung: phải tính thời gian kiểm tra, số mẫu cần xem bằng tay và chi phí xử lý lỗi trước khi so sánh các model. Nếu bỏ qua khoản này, đội marketing dễ chọn model có câu chuyện hấp dẫn nhưng tốn nhiều công sức giám sát.
Chưa xác nhận: quy mô Robotaxi và ý nghĩa của lần gọi Grok
Có phải màn công bố Robotaxi nhằm tạo kỳ vọng cho cuộc gọi kết quả?
Mike P phỏng đoán việc công bố Tampa và Orlando ngay trước cuộc gọi kết quả có thể tạo cảm giác “pump”. Đây là nhận xét cá nhân dựa trên quan sát rằng số xe ít và geofence chưa mở rộng; doanh nghiệp chưa được nguồn này xác nhận là có chủ ý như vậy. Điều dùng được: đội marketing không nên lặp lại cáo buộc. Hãy tách ngày công bố, số lượng triển khai được xác nhận, phạm vi phục vụ và chỉ số sử dụng thành các cột riêng trong dashboard.
Lời gọi Grok có thể xác nhận năng lực Robotaxi đến đâu?
Mike P đặt câu hỏi với tài khoản Grok, nhưng nguồn không có câu trả lời xác nhận nào từ Grok. Vì vậy, đây chỉ là lời kỳ vọng của người dùng về khả năng AI cung cấp kiểm chứng độc lập, không phải bằng chứng model đã đánh giá được Robotaxi. Điều dùng được: marketer nên xem câu trả lời của chatbot là đầu vào để tìm tài liệu gốc, không phải nguồn kết luận; mọi nhận định quan trọng cần quay về log, tài liệu kỹ thuật hoặc kết quả thử nghiệm có thể kiểm tra.
Tại thị trường Việt Nam, mô hình AI cần đi qua phạm vi thử nghiệm
Doanh nghiệp Việt Nam thường phải cân đối ngân sách, nhân sự kiểm duyệt và dữ liệu riêng. Vì vậy, một model được nhắc nhiều chưa chắc phù hợp bằng model có thể chạy trong một workflow nhỏ với đầu ra ổn định. Bài học từ geofence là phải công bố rõ “vùng dùng được”; bài học từ tranh luận quanh hình ảnh thương hiệu là phải phân biệt lời kể với bằng chứng.
Với content marketing, có thể bắt đầu bằng một nhóm truy vấn cụ thể như viết biến thể tiêu đề, phân loại brief hoặc tóm tắt phản hồi khách hàng. Đội ngũ cần lưu prompt, đầu ra, lỗi và thời gian sửa. Khi mở rộng sang chatbot, quảng cáo hoặc chăm sóc khách hàng, các chỉ số đó giúp so sánh model bằng công việc thật, thay vì bằng độ nổi tiếng của tên model.
Đặt log và ngưỡng duyệt trước khi dùng mô hình AI
- Chọn một workflow hẹp và định nghĩa đầu ra đạt trước khi mua thêm công cụ hoặc tăng ngân sách API.
- Ghi riêng phạm vi model được phép xử lý, tình huống phải chuyển cho người và dữ liệu không được đưa vào prompt.
- Đo tỷ lệ hoàn tất, thời gian sửa, lỗi lặp lại và chi phí cho mỗi tác vụ; không dùng số lượt triển khai làm chỉ số duy nhất.
- Kiểm tra lại mọi tuyên bố về năng lực bằng tài liệu gốc hoặc mẫu thử của chính doanh nghiệp trước khi đưa vào thông điệp marketing.
Xem thêm phân tích & hướng dẫn marketing tại https://marketing365.vn.
Theo dõi thêm các bài phân tích từ Marketing365 để cập nhật xu hướng marketing mới nhất.
Đọc thêm các bài cùng chuyên mục Động thái AI.
Nguồn tham khảo
- DogeDesigner — The teaser for Alex Gibney’s Musk documentary is out
- Mike P — Tesla Robotaxi deployments in Tampa and Orlando