Nội dung
- Bối cảnh model mới: năng lực chỉ có giá trị khi đo được đầu ra
- Những thay đổi trong model mới — chạm tới cách marketing kiểm soát AI
- Đường đi của đầu ra AI: từ trí nhớ đến bài phân tích có thể kiểm tra
- Grok 4.7 chưa xác nhận: người mua nên kiểm gì?
- Dữ liệu tiếng Việt quyết định model mới có dùng được ở Việt Nam
- Chốt workflow model AI trước khi tăng ngân sách
- Nguồn tham khảo
Model AI mới không còn được đánh giá chỉ bằng câu trả lời nghe tự nhiên hay màn trình diễn trên sân khấu. Giá trị thực tế đang chuyển sang khả năng ghi nhớ đúng ngữ cảnh, tự làm trong phạm vi được phép và dừng lại khi dữ liệu hoặc phép kiểm tra không đạt. Với marketer Việt Nam, thay đổi này ảnh hưởng trực tiếp đến cách chọn công cụ, thiết kế workflow và duyệt nội dung.
Điểm chính
- Model có thêm trí nhớ và quyền tự làm nhưng không tự tạo ra độ tin cậy.
- AI Economist Agent cho thấy mỗi con số cần đi qua nguồn, mô hình và bài kiểm tra trước khi vào báo cáo.
- Khung công khai về model misalignment biến việc ghi log và xử lý sai lệch thành một phần của vận hành AI.
- Marketer Việt nên thử trên workflow hẹp, dữ liệu tiếng Việt thật và tiêu chí duyệt cụ thể trước khi tăng ngân sách.
Bối cảnh model mới: năng lực chỉ có giá trị khi đo được đầu ra
Sáu diễn biến trong tư liệu cùng chỉ về một điểm: model AI đang tiến gần hơn tới công việc có nhiều bước, nhưng cách chứng minh chất lượng vẫn chưa theo kịp khả năng tạo nội dung. Bài giới thiệu về memory trong Grok Build gợi ra nhu cầu duy trì ngữ cảnh; khung AI Economist Agent của Đại học Tokyo lại đặt nguồn dữ liệu, quan hệ giữa các yếu tố, mô hình định lượng và acceptance test vào cùng một quy trình. Xem ghi chú về Memory in Grok Build và mô tả AI Economist Agent.
Ở phía an toàn, OpenAI công bố một khung theo dõi, điều tra và công khai các trường hợp model misalignment, kể cả khi nguyên nhân hoặc cách giảm rủi ro chưa hoàn chỉnh. METR cũng mô tả mục tiêu của họ là giúp công chúng biết khi AI khó điều khiển hoặc tiến gần trạng thái mất kiểm soát. Hai hướng này cho thấy model mới không chỉ là một sản phẩm phần mềm; nó là một thành phần cần được theo dõi trong cả vòng đời công việc.
Những thay đổi trong model mới — chạm tới cách marketing kiểm soát AI
Khối cập nhật dưới đây chỉ giữ những thứ có mô tả cụ thể trong tư liệu: tính năng memory, quy trình công khai sai lệch và framework phân tích có bài kiểm tra.
Memory trong Grok Build: đội nội dung phải quản lý ngữ cảnh
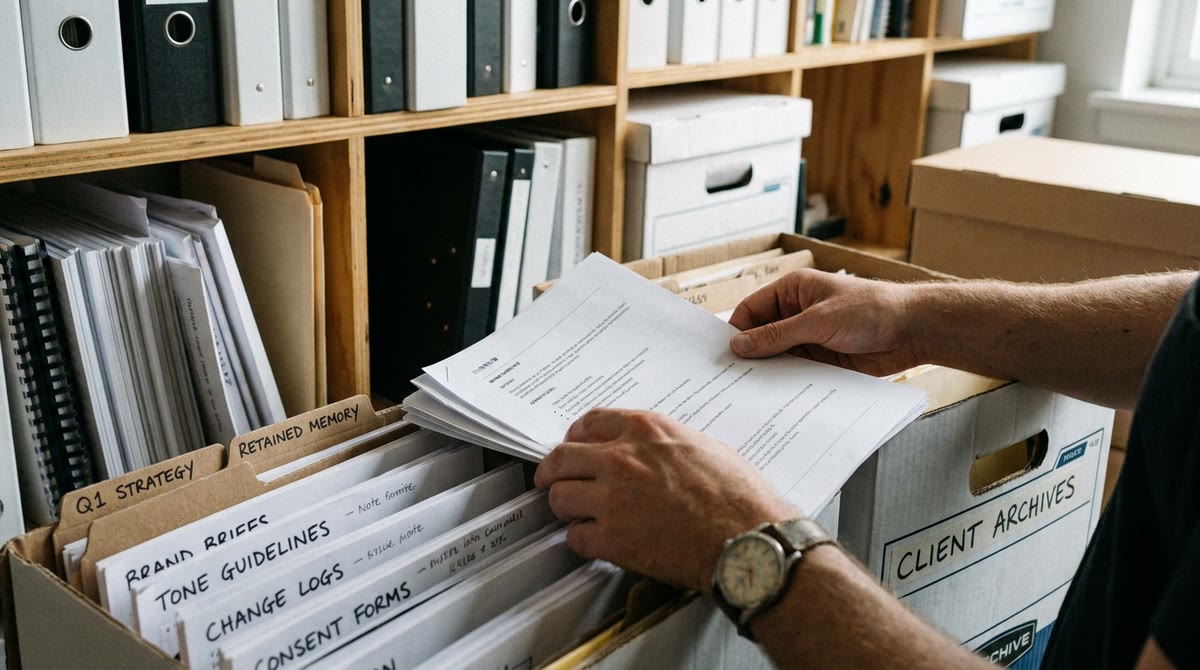
Memory trong Grok Build là cơ chế giúp model giữ lại thông tin liên quan trong quá trình làm việc. Với marketing, nó có thể chạm tới brief thương hiệu, quy tắc giọng nói, lịch sử chỉnh sửa và yêu cầu của từng khách hàng. Đội ngũ không nên xem trí nhớ như nơi lưu mọi dữ liệu. Cần quy định thông tin nào được giữ, ai được sửa và khi nào phải xoá hoặc kiểm tra lại. Chi tiết tính năng được nêu trong Tech Dev Notes.
Khung công khai misalignment: quy trình AI phải có log và đường xử lý
Khung của OpenAI đặt tiêu chí và thời điểm công khai cho các trường hợp model có hành vi lệch mục tiêu. Nó ưu tiên những trường hợp cho thấy cơ chế sai lệch mới, thay đổi trong hành vi đã biết hoặc thách thức giả định về an toàn. Với đội marketing, điều này chuyển thành yêu cầu lưu prompt, đầu vào, đầu ra, người duyệt và cách xử lý khi model làm sai. Tham chiếu trực tiếp là khung theo dõi misalignment của OpenAI.
AI Economist Agent: báo cáo phải qua nguồn và acceptance test
AI Economist Agent tổ chức phân tích theo chuỗi bằng chứng, cơ chế kinh tế, mô hình đã đăng ký, bài kiểm tra rồi mới tạo báo cáo. Knowledge graph giữ quan hệ giữa các yếu tố cùng nguồn, ngày và phạm vi; nếu nguồn, đầu vào hoặc kết quả không đạt điều kiện, quy trình dừng lại. Đây là cách thiết kế phù hợp cho dashboard, phân tích thị trường và dự báo ngân sách khi marketer cần giải thích vì sao một con số xuất hiện. Xem mô tả framework từ Đại học Tokyo.
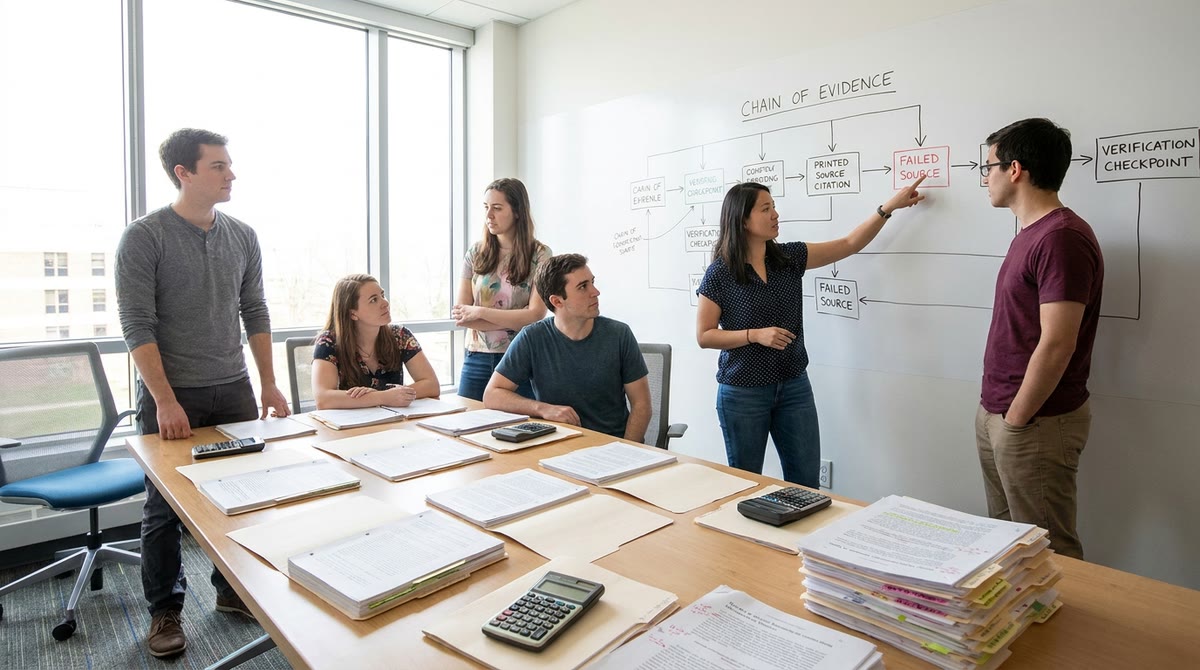
Đường đi của đầu ra AI: từ trí nhớ đến bài phân tích có thể kiểm tra
Trí nhớ dài hơn làm người dùng đổi cách đánh giá câu trả lời
Khi model giữ được nhiều ngữ cảnh, người dùng có xu hướng giao việc dài hơn và kiểm tra ít hơn ở từng bước. Memory trong Grok Build tạo ra lý do để người dùng kỳ vọng một cuộc hội thoại liền mạch; AI Economist Agent lại cho thấy ngữ cảnh chỉ có ích khi từng quan hệ vẫn gắn với nguồn và phạm vi. Hai ví dụ này cùng chỉ ra một cơ chế hành vi: người mua không chỉ so câu trả lời đầu tiên, mà so khả năng duy trì đúng yêu cầu qua cả workflow.
Vì vậy, benchmark một lượt chat không đủ để chọn công cụ. Marketer cần thử một chuỗi công việc có brief, dữ liệu bổ sung, vòng sửa và đầu ra cuối. Chỉ số nên là tỷ lệ đầu ra đạt ngay, số lần người làm phải sửa và thời gian kiểm tra.
Acceptance test biến lời văn trôi chảy thành đầu ra phải chịu kiểm tra
AI Economist Agent đặt bài kiểm tra trước khi con số được đưa vào báo cáo. Khung misalignment của OpenAI cũng nhấn mạnh việc ghi nhận hành vi, điều tra và công khai ngay cả khi chưa giải thích đầy đủ. Khi đặt hai cách tiếp cận cạnh nhau, có thể thấy tiêu chuẩn tin cậy không còn là “model viết nghe hợp lý”, mà là “đội ngũ có biết nó lấy gì, làm gì và dừng ở đâu hay không”.
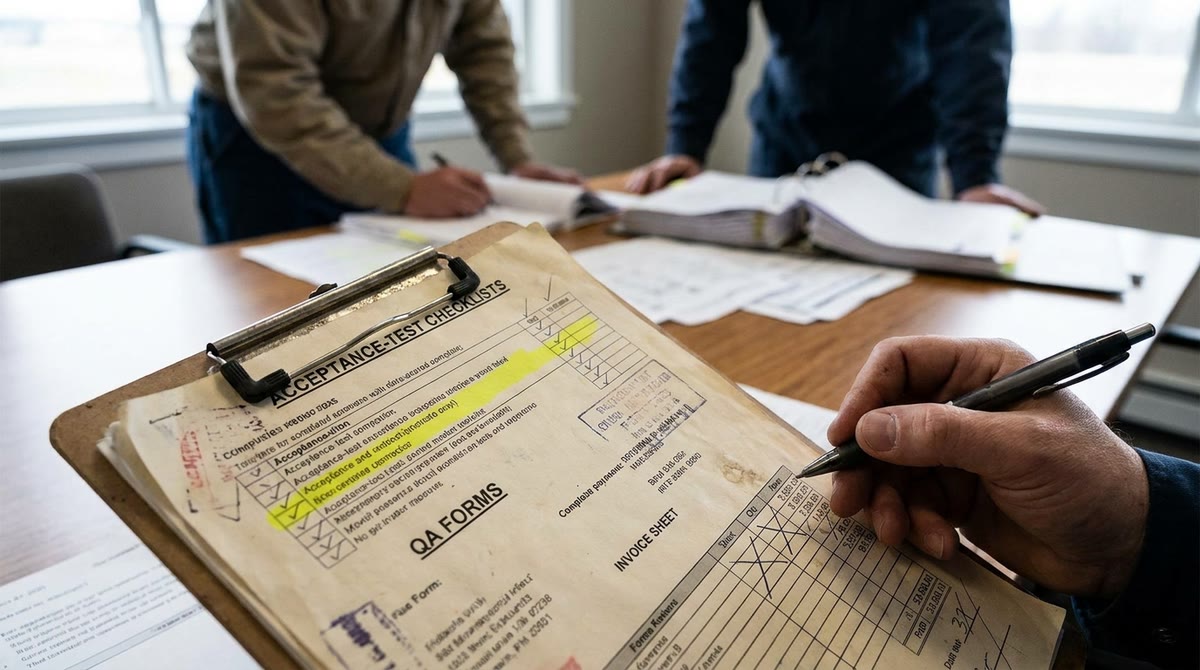
Điều này thay đổi hành vi mua công cụ. Một model rẻ hơn nhưng không có log, không cho xem nguồn hoặc khó kiểm thử có thể tạo thêm việc cho biên tập viên. Ngược lại, một công cụ ít hào nhoáng hơn nhưng cho phép kiểm tra từng bước có thể phù hợp hơn với nội dung tài chính, y tế hoặc quảng cáo có cam kết.
Quyền tự chạy chỉ có giá trị khi người dùng giữ được điểm dừng
METR mô tả nhiệm vụ của họ là tìm bằng chứng về AI có thể tự chủ, khó điều khiển hoặc gần mất kiểm soát; OpenAI cũng công bố quy trình theo dõi hành vi lệch mục tiêu. Các nguồn này không chứng minh rằng một model cụ thể đã mất kiểm soát. Chúng cho thấy ranh giới giữa “tự làm” và “tự quyết định” phải được thiết kế rõ.
Với marketing, điểm dừng có thể là không gửi email nếu thiếu trường dữ liệu, không xuất bản quảng cáo nếu claim chưa có nguồn, hoặc chuyển sang người duyệt khi confidence thấp. Cách này bảo vệ hành vi ra quyết định của người dùng cuối: họ vẫn có thể so sánh, hỏi lại và sửa kết quả thay vì nhận một đầu ra trông hoàn chỉnh nhưng khó truy nguyên.
Grok 4.7 chưa xác nhận: người mua nên kiểm gì?
Người dùng có đang nhầm lời hẹn phát hành với năng lực đã kiểm chứng?
Một bài đăng của Rajath Gowda mô tả cảm giác chờ đợi quanh Grok 4.7 và nhắc các mốc hẹn thay đổi. Đây là lời kể cá nhân về một lần phát hành được chờ đợi, không phải xác nhận chính thức về tính năng, chất lượng hay thời điểm cung cấp của model. Tư liệu không đủ để kết luận Grok 4.7 có năng lực nào.
Điều dùng được: đội marketing không nên lập ngân sách dựa trên lời hẹn hoặc cảm giác từ cộng đồng. Hãy yêu cầu bản demo có thể kiểm tra, chạy cùng một bộ prompt với công cụ đang dùng, đo tỷ lệ đạt và ghi lại chi phí sửa trước khi đưa model vào kế hoạch.
Dữ liệu tiếng Việt quyết định model mới có dùng được ở Việt Nam
Người dùng Việt thường tìm thông tin bằng tiếng Việt nhưng có thể chuyển sang tiếng Anh khi cần so sánh hoặc kiểm tra nguồn. Model có memory và khả năng tự làm vì thế phải được thử trên brief, tên sản phẩm, cách nói địa phương, quy định ngành và dữ liệu khách hàng thật đã ẩn thông tin nhạy cảm. Một câu trả lời trôi chảy chưa cho biết model hiểu đúng ý định mua hàng.
Đội marketing nên đo ba điểm: model có giữ đúng thuật ngữ thương hiệu không, có trích sai nguồn tiếng Việt không và người duyệt mất bao lâu để sửa. Các bài test cần có nhóm truy vấn khó, chẳng hạn từ viết tắt, tên địa danh, cách gọi sản phẩm và câu hỏi có nhiều ý. Kết quả này hữu ích hơn việc chỉ xem bảng xếp hạng chung.
Chốt workflow model AI trước khi tăng ngân sách
- Chọn một workflow hẹp như viết landing page hoặc phân loại lead; ghi rõ đầu vào, đầu ra và người chịu trách nhiệm duyệt.
- Tạo bộ test tiếng Việt gồm brief thật đã ẩn dữ liệu nhạy cảm, câu hỏi khó và các trường hợp phải từ chối.
- Lưu prompt, nguồn, phiên bản model, đầu ra và số vòng sửa để tính tổng thời gian thực tế.
- Chỉ mở rộng quyền tự làm sau khi tỷ lệ đạt, thời gian kiểm tra và điểm dừng đã được thống nhất bằng văn bản.
Xem thêm phân tích & hướng dẫn marketing tại https://marketing365.vn.
Theo dõi thêm các bài phân tích từ Marketing365 để cập nhật xu hướng marketing mới nhất.
Đọc thêm các bài cùng chuyên mục Động thái AI.
Nguồn tham khảo
- OpenAI — Framework for tracking, investigating, and disclosing model misalignment
- Chris Painter / METR — About evaluating autonomous and difficult-to-steer AI
- Tech Dev Notes — Memory in Grok Build
- Beamnxw — AI Economist Agent framework from the University of Tokyo
- Rajath Gowda — Commentary on the expected Grok 4.7 release