Nội dung
- Hạ tầng AI chuyển cuộc đua từ model sang năng lực phục vụ
- Speculative decoding và GPU phổ thông chạm tới việc đội marketing phải làm khác đi
- Quyền mặc cả nằm ở chi phí inference và khả năng đưa model ra thị trường
- Doanh nghiệp Việt Nam cần nhìn hạ tầng AI qua bài toán tỷ lệ dùng thật
- Đo chi phí mỗi tác vụ trước khi mở rộng ngân sách AI
- Nguồn tham khảo
Hạ tầng AI đang trở thành yếu tố quyết định quyền mặc cả giữa doanh nghiệp và nhà cung cấp model, không chỉ vì số lượng chip. Với marketer Việt Nam, thay đổi này chạm trực tiếp vào ngân sách thử nghiệm, tốc độ đưa AI vào workflow và khả năng duy trì dịch vụ khi nhu cầu tăng.
Luận điểm của bài viết là: lợi thế không còn nằm riêng ở model có điểm benchmark cao, mà ở hệ thống có thể phục vụ nhiều lượt dùng với chi phí đo được và phân phối đủ rộng.
Điểm chính
- Chi phí inference phụ thuộc cả tốc độ sinh token lẫn cách tận dụng phần cứng.
- Speculative decoding và model chạy được trên GPU phổ thông làm giảm rào cản tiếp cận AI.
- Quy mô compute lớn chỉ có ý nghĩa khi đi cùng doanh thu, mức sử dụng và biên phục vụ.
- Doanh nghiệp Việt nên mua năng lực phục vụ theo workflow, không mua theo số chip hoặc điểm số đơn lẻ.
Hạ tầng AI chuyển cuộc đua từ model sang năng lực phục vụ
Ba diễn biến trong các nguồn cho thấy cùng một hướng dịch chuyển. Bài hướng dẫn về speculative decoding của Lily Zhang và Madison Kanna mô tả nút thắt phổ biến của LLM: model tạo từng token một, khiến tốc độ inference bị giới hạn. Trong khi đó, phân tích về Anthropic cho thấy cuộc chơi đã kéo sang hàng gigawatt compute, nhiều loại phần cứng và các cam kết mua năng lực rất lớn. (Nguồn về speculative decoding; Phân tích về compute của Anthropic)
Ở đầu còn lại, một subnet của Bittensor đưa checkpoint Qwen 3.8 27B lên Hugging Face và ghi nhận hơn 500.000 lượt tải; model có thể chạy trên một RTX 5090. Con số này không chứng minh 500.000 máy đang chạy model, nhưng cho thấy phân phối model qua phần cứng người dùng có thể tạo ra một kênh tiếp cận khác với việc phụ thuộc hoàn toàn vào data center. (Tổng hợp hoạt động các subnet)
Speculative decoding và GPU phổ thông chạm tới việc đội marketing phải làm khác đi
Khối cập nhật dưới đây chỉ ghi nhận những công nghệ hoặc số liệu được nêu trực tiếp trong tư liệu. Điểm chung là chúng làm thay đổi cách đội marketing đánh giá một công cụ AI.
Speculative decoding: đo tốc độ phục vụ thay vì chỉ nhìn model
Speculative decoding dùng một model nhỏ để đề xuất chuỗi token, sau đó model lớn kiểm tra các đề xuất đó. Cách làm này nhằm rút ngắn thời gian tạo câu trả lời trong các tác vụ autoregressive. Tài liệu của Lily Zhang và Madison Kanna gọi đây là chủ đề quan trọng trong LLM stack và cho biết kỹ thuật này đã được dùng dưới nhiều dịch vụ LLM được host. Với marketing, chỉ số cần theo dõi không dừng ở chất lượng đầu ra; latency, số lượt phục vụ mỗi giờ và chi phí cho mỗi tác vụ cũng phải vào dashboard. (Tài liệu speculative decoding)
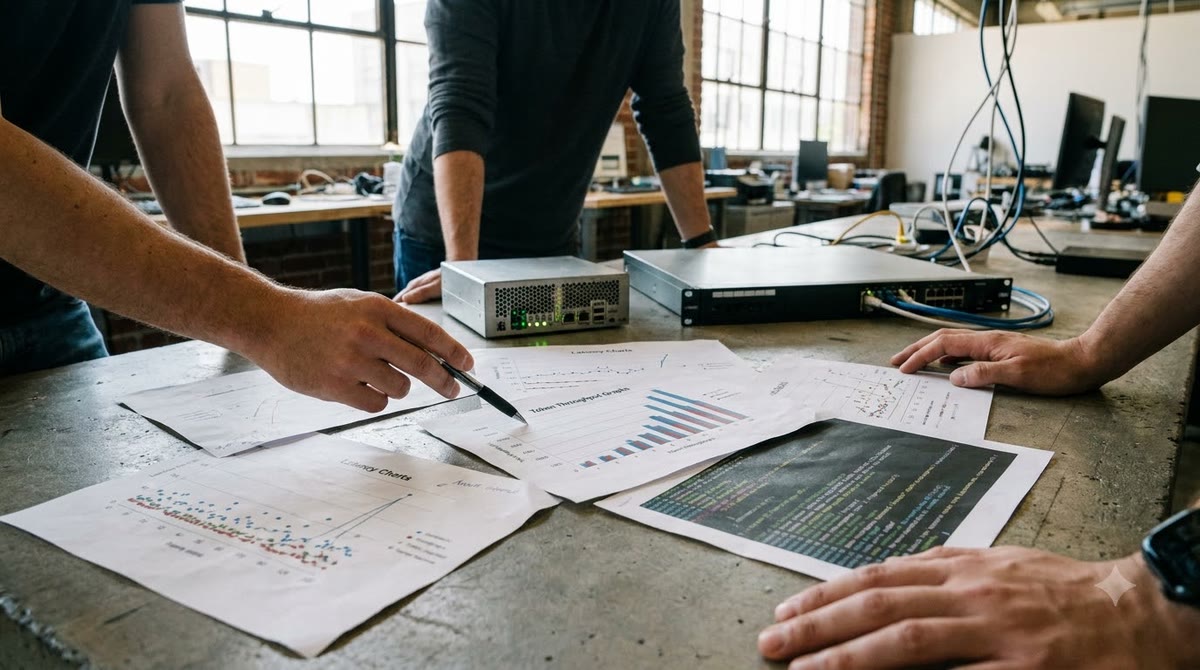
Checkpoint chạy trên RTX 5090: mở rộng thử nghiệm ngoài cụm máy chủ
Checkpoint Qwen 3.8 27B được mô tả là chạy trên một RTX 5090 và đã vượt 500.000 lượt tải trên Hugging Face. Đây là dấu hiệu về khả năng phân phối model tới developer và nhóm thử nghiệm có phần cứng tiêu dùng, không phải bằng chứng về chất lượng sản phẩm cuối cùng. Đội marketing có thể dùng loại model này cho prototyping, tạo dữ liệu thử và kiểm tra workflow nội bộ trước khi trả tiền cho API ở quy mô lớn. (Thông tin checkpoint và lượt tải)
Compute đa phần cứng: yêu cầu so sánh hiệu quả phục vụ theo workload
Phân tích về Anthropic nêu việc Claude sử dụng AWS Trainium, Google TPU và phần cứng Nvidia, cùng kế hoạch có tới 2 GW hệ thống AMD từ năm 2027. Chi tiết này cho thấy cùng một nhu cầu AI có thể được phục vụ trên nhiều loại chip. Marketer không cần tự chọn chip ở cấp kỹ thuật, nhưng cần yêu cầu nhà cung cấp công bố latency, giới hạn tải, thời gian gián đoạn và giá theo tác vụ thay vì chỉ đưa ra tên model. (Phân tích phần cứng Anthropic)
Quyền mặc cả nằm ở chi phí inference và khả năng đưa model ra thị trường
Chi phí inference biến tốc độ token thành điều kiện mua công cụ
LLM tạo từng token một nên mỗi cải thiện về tốc độ phục vụ có thể ảnh hưởng đến ngân sách khi số lượt dùng tăng. Speculative decoding xử lý đúng điểm nghẽn này, còn các kế hoạch compute lớn của Anthropic cho thấy nhà cung cấp phải liên tục mua thêm năng lực để đáp ứng nhu cầu. Hai nguồn đặt cạnh nhau cho thấy người mua có cơ sở đàm phán tốt hơn nếu họ yêu cầu giá gắn với thời gian phản hồi và sản lượng thực tế, thay vì chấp nhận bảng giá tách rời khỏi hiệu suất. (Nguồn speculative decoding; Nguồn compute Anthropic)
Model chạy trên phần cứng phổ thông làm giảm phí thử nghiệm ban đầu
Checkpoint có thể chạy trên RTX 5090 và kỹ thuật tối ưu inference cùng chỉ ra một thay đổi trong cấu trúc thị trường: thử nghiệm model không nhất thiết bắt đầu bằng hợp đồng cloud lớn. Một đội có thể kiểm tra prompt, dữ liệu và luồng phê duyệt trên máy cục bộ, rồi chỉ đưa tác vụ đã chứng minh giá trị lên hạ tầng trả phí. Điều này làm tăng quyền lựa chọn của người mua, dù chưa thay thế được yêu cầu về bảo mật, uptime và khả năng mở rộng. (Nguồn checkpoint; Nguồn tối ưu inference)
Cam kết compute lớn không đồng nghĩa biên phục vụ đã tốt
Phân tích về Anthropic nêu ít nhất 14,8 GW compute được thu xếp và chi phí tiềm năng lên tới 517 tỷ USD trong một thập kỷ, đồng thời nhấn mạnh cần nhìn cả mức sử dụng và biên serving. Đây là điểm quan trọng khi đọc các tuyên bố về hạ tầng. Một model có nhiều chip phía sau vẫn có thể tạo áp lực lên giá nếu tải thực tế chưa đủ. Ngược lại, model được tải nhiều và chạy trên GPU phổ thông có thể tạo sức ép cạnh tranh ở khâu phân phối. (Nguồn về compute, doanh thu và biên serving; Nguồn về phân phối model)
Doanh nghiệp Việt Nam cần nhìn hạ tầng AI qua bài toán tỷ lệ dùng thật
Thị trường Việt Nam khó có lợi thế nếu chỉ mua quyền truy cập model đắt tiền rồi để đội ngũ tự tìm cách dùng. Nhiều nhóm marketing cần bắt đầu từ các tác vụ có lưu lượng rõ: tạo biến thể nội dung, phân loại phản hồi, hỗ trợ nghiên cứu khách hàng hoặc kiểm tra dữ liệu chiến dịch.
Với tác vụ nhẹ, model chạy trên GPU phổ thông có thể phù hợp cho giai đoạn thử nghiệm, nhưng doanh nghiệp vẫn phải kiểm tra bản quyền dữ liệu, bảo mật và khả năng vận hành. Với tác vụ cần phản hồi nhanh hoặc có lượng truy cập lớn, cần so sánh nhiều nhà cung cấp dựa trên chi phí mỗi tác vụ, thời gian phản hồi và mức cam kết dịch vụ. Đây là cách biến sự đa dạng về chip và model thành quyền lựa chọn, thay vì biến nó thành một danh sách công nghệ khó đánh giá.
Đo chi phí mỗi tác vụ trước khi mở rộng ngân sách AI
- Chọn một workflow marketing cụ thể và ghi lại số lượt gọi model, thời gian phản hồi, tỷ lệ phải sửa và chi phí cho mỗi đầu ra.
- Chạy cùng một bộ kiểm thử trên model cloud và model có thể vận hành bằng GPU phổ thông; không kết luận chỉ từ điểm benchmark.
- Đưa các câu hỏi về uptime, giới hạn tải, phần cứng sử dụng và cách tính phí vào quy trình mua công cụ.
- Chỉ tăng ngân sách khi tỷ lệ dùng thật, chất lượng đầu ra và tổng tiền phải bỏ ra đều được theo dõi trên cùng một dashboard.
Xem thêm phân tích & hướng dẫn marketing tại https://marketing365.vn.
Theo dõi thêm các bài phân tích từ Marketing365 để cập nhật xu hướng marketing mới nhất.
Đọc thêm các bài cùng chuyên mục Động thái AI.
Nguồn tham khảo
- Introducing Speculative Decoding: How It Evolved, When It Stays Lossless, and What’s Next
- While people argue whether $TAO is a real AI play, one of its subnets put a model on 500,000 machines
- The Information just reported Anthropic has lined up at least 14.8 GW of new compute since October